《Composing Programs》第三版 · 中文版
原书:Composing Programs (3rd Edition) — John DeNero(Berkeley CS61A 教材) 本译本覆盖 第 1 章 Functions 与 第 2 章 Building Abstractions with Data
译注:原文中的专有名词(语言名、工具名、人名、网址、代码标识符)一律保留原样, 以保证与官方文档、cs61a.org 作业和代码示例对得上。
翻译进度
| 小节 | 原文词数 | 状态 |
|---|---|---|
| 1.1 Getting Started | 1,419 | ✅ 已完成 |
| 1.2 Elements of Programming | 2,586 | ✅ 已译(编程的基本要素) |
| 1.3 Defining New Functions | 3,440 | ✅ 已译(定义新函数) |
| 1.4 Designing Functions | 770 | ✅ 已译(设计函数) |
| 1.5 Control | 2,623 | ✅ 已译(控制) |
| 1.6 Higher-Order Functions | 4,899 | ✅ 已译(高阶函数) |
| 1.7 Recursive Functions | 2,676 | ✅ 已译(递归函数) |
| Functions Reference 函数参考 | 1,160 | ✅ 已译 |
| 2.1 Introduction | 1,606 | ✅ 已译(引言) |
| 2.2 Sequences | 4,255 | ✅ 已译(序列) |
| 2.3 Compound Data | 3,844 | ✅ 已译(复合数据) |
| 2.4 Mutable Data | 3,061 | ✅ 已译(可变数据) |
| 2.5 Object-Oriented Programming | 4,798 | ✅ 已译(面向对象编程) |
| 2.6 Implementing Classes and Objects | 1,408 | ✅ 已译(实现类与对象) |
| 2.7 Object Abstraction | 1,396 | ✅ 已译(对象抽象) |
| 2.8 Lazy Evaluation | 3,100 | ✅ 已译(惰性求值) |
第 1 章 函数
1.1 起步
计算机科学是一门范围广阔的学科。全球分布式系统、理论、机器人、图形学、安全、计算机体系结构,以及数十个新兴子领域,每年都在涌现新的技术与发现。计算机科学的高速进展几乎触及人类生活的方方面面,而人工智能的进步正在进一步加快这一变化的速度。商业、通信、科学、艺术、休闲与政治,如今都已成为计算的主场。
计算机科学之所以影响深远,很大程度上源于一组优雅而强大的基本思想:一切计算都始于表示信息,进而指定处理这些信息的求解逻辑,再创建抽象以驾驭这份逻辑的复杂度。编程语言是人类最聪慧、最灵活的发明之一,也正是这些思想得以表达的载体。理解计算机程序如何书写与组织、计算机又如何运行程序来完成计算过程,正是创造新程序、进一步拓展计算机科学影响力的必备基础。
长期以来,这些基本思想都是借助经典教材《计算机程序的构造和解释》(Structure and Interpretation of Computer Programs,简称 SICP)来传授的。该书由 Harold Abelson 与 Gerald Jay Sussman 主笔、Julie Sussman 参与,于 1984 年首次出版。本书大量借鉴了这本教材,原作者也已慷慨授权改编与复用。
《Composing Programs》第三版关注的是:如何借助人工智能(AI)工具来编写、扩展和理解计算机程序。若只是让 AI 写出一个已被完整、精确描述的程序,根本不需要任何人类技能。然而,要创造出新颖而有用的程序,总得有人去构思并把它描述出来——而在今天,这往往仍需要与从零编写程序同样扎实的理解:对表示、逻辑、抽象和编程语言的透彻掌握。有了 AI,一个简短的描述就能生成或改写大段程序,创造的效率因此大幅提升;但设想程序的设计、准确地描述它、并改进 AI 给出的产物,这份人类的专业能力依旧是造程序的核心。学习如何有效地用 AI 开发程序,最好的时机正是掌握了这些核心理解之后——这也正是本书把该主题放在末尾的原因。
用 Python 编程
语言与其说是你学会的东西,不如说是你加入的共同体。 —— Arika Okrent
本书主要使用 Python 语言。
Python 是一门广泛使用的编程语言,拥趸来自各行各业:Web 程序员、游戏工程师、科学家、学者,乃至新编程语言的设计者。学会 Python,你就加入了一个规模达百万级的开发者社区。开发者社区是极其重要的机构:成员互相帮忙解决问题,分享自己的项目与经验,共同打造软件与工具。其中热忱的成员常常因其贡献而赢得名声与广泛敬重。
Python 语言本身就是一大群志愿者的产物,他们以贡献者的多元为傲。这门语言由 Guido van Rossum 于 1980 年代末构思并首次实现。在其 Python 3 教程 的第一章里,他解释了在如今众多语言之中,Python 为何如此受欢迎。
作为教学语言,Python 表现优异,因为纵观其历史,Python 的开发者一直强调 Python 代码的人可读性,并以《Python 之禅》(Zen of Python)中美、简洁、易读的指导原则加以强化。本书之所以格外适合用 Python,是因为它丰富的特性支持多种不同的编程风格,我们将在书中逐一探索。
开始学 Python 编程最好的方式,就是直接与解释器互动。本节介绍如何安装 Python 3 与 Visual Studio Code 编辑器,随后启动一次交互式会话、开始写程序。这些软件全部免费,全球数百万程序员日常都在使用。
安装 Python 3
请使用适用于你操作系统的官方安装程序来安装 Python。始终选择版本号以 3 开头、且标注为 stable 的版本,例如 3.14.7。版本号越大越好。
Windows。 从 Windows 下载页面下载 64 位安装程序并运行。在安装程序的第一个界面上,先勾选标注为 Add python.exe to PATH 的复选框,再点击 Install Now。
Mac。 从 macOS 下载页面下载 64 位 universal2 安装程序,打开下载好的 .pkg 文件,按安装程序的提示操作。
安装与配置 Visual Studio Code
编辑器是用来编写和修改程序的应用程序。Visual Studio Code(通常简称 VS Code)是目前全球最流行的编辑器。
请使用适用于你操作系统的官方安装程序安装 Visual Studio Code,可从 Visual Studio Code 下载页面获取。
Windows。 下载 Windows x64 User Installer 并运行。
Mac。 下载 Mac Universal 归档包,打开下载的文件,把 Visual Studio Code 应用拖进「应用程序」文件夹。
首次打开 VS Code 时,如果它要求你登录以使用 GitHub Copilot 的 AI 功能或其他功能,直接关掉登录窗口即可——无需登录 VS Code。
VS Code 安装并打开后,还有两个重要步骤。如果你打开的是本版教材的配套作业(例如 cs61a.org 上的 lab、homework 或 project),这些步骤应当会自动完成。如果只是想自己写程序,请手动完成这两步:
- 添加 Python 支持:点击左侧边栏的扩展图标,搜索
python,安装名为 Python、发布者为 Microsoft 的扩展。它应排在第一位,描述以「Python language support」开头。 - 关闭 GitHub Copilot:搜索
copilot,点击预装的 GitHub Copilot Chat 扩展。在打开的扩展说明页顶部附近,点击「Disable AI Features」,然后关闭扩展页面。
交互式会话
在交互式 Python 会话中,你在提示符 >>> 之后输入代码。Python 解释器会读取并执行你输入的内容,依次完成你的各种命令。
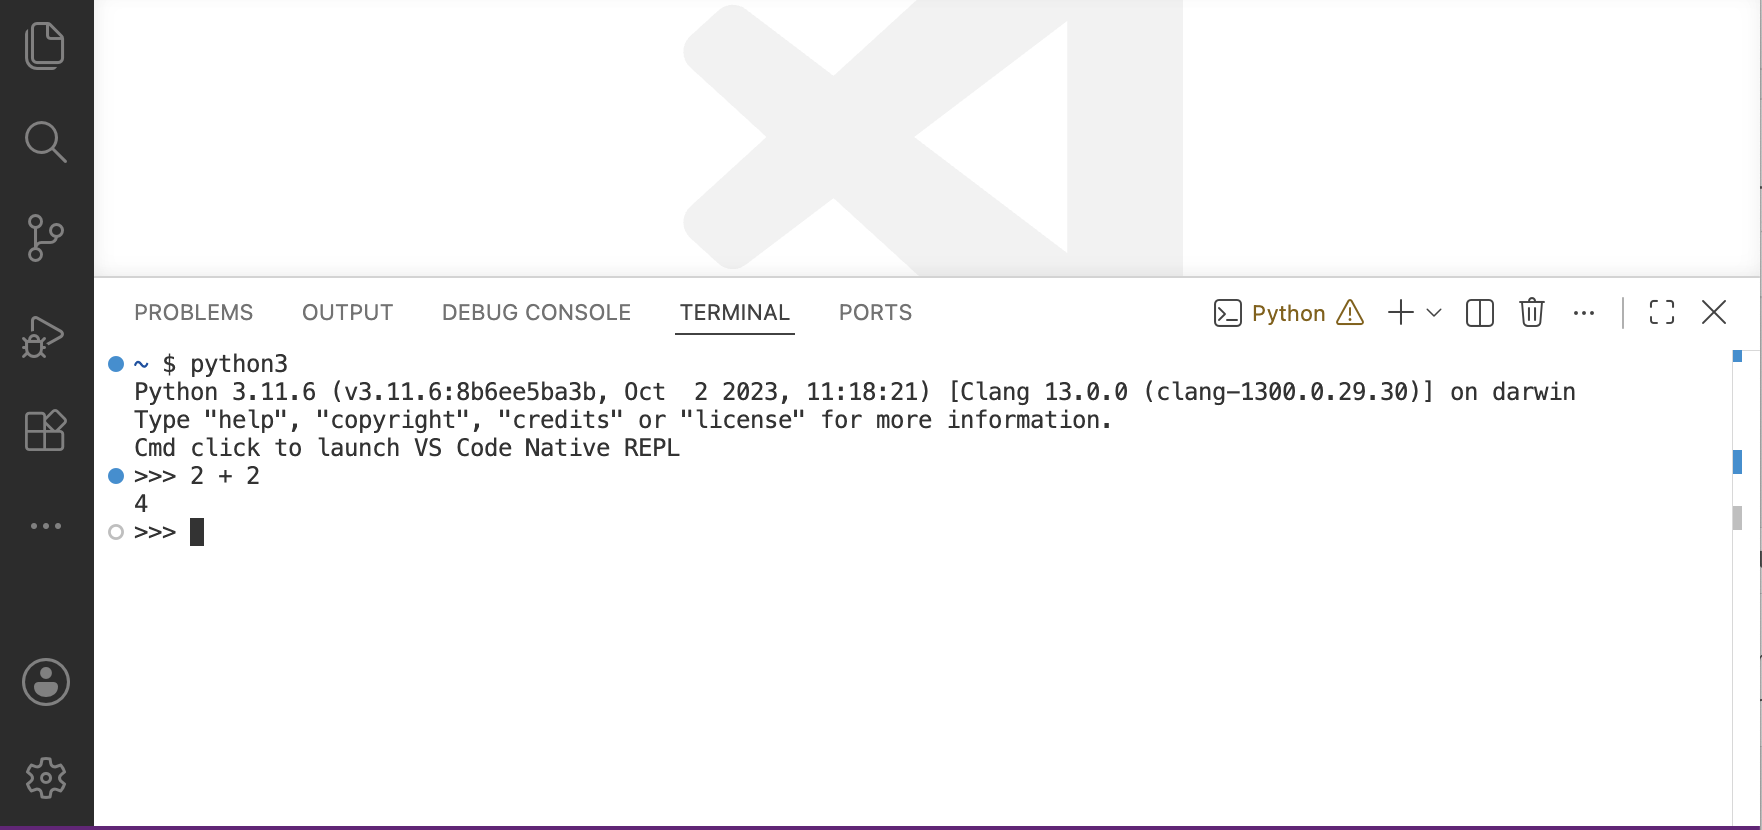
要在 VS Code 内启动交互式会话,先从 Terminal 菜单中选择 New Terminal,然后输入 py(Windows)或 python3(Mac/Linux)来启动 Python 解释器。
如果看到 Python 提示符 >>>,说明你已经成功进入交互式会话。试着输入 2 + 2 并按回车(Windows)或 return(Mac/Linux),你应该会看到答案 4。
>>> 2 + 2
4
在 VS Code 里,运行 Python 解释器的终端看起来大致如下:
小技巧:上下方向键可以翻阅你此前写过的 Python 代码历史。
错误
Python 正等着你的命令。鼓励你大胆尝试这门语言。在本章余下的部分,请把你读到的表达式敲进去、来回改改,看看会发生什么。不过,也要做好出错的准备。编程语言固然强大,却也极其死板:哪怕拼写或格式上最微小的改动,也会带来意想不到的输出和报错。
学会解读错误、定位意外错误的成因,这门功夫叫调试(debugging)。调试有几条指导原则:
- 增量测试:每个写得好的程序,都由小而模块化的部件组成,每个部件都能单独试验。不要一上来就写又长又复杂的表达式,先对它的各个部分求值,确认结果符合预期。这样做能及早发现问题,也让你对自己的部件更有把握。
- 隔离错误:某条语句输出上的错误,通常可以归因到代码中的某个具体位置。诊断时,先把错误追踪到尽可能小的代码片段,再动手修改。
- 检验假设:解释器会一字不差地执行你的指令——不多也不少。当我们观察到的行为与程序员所相信(或假设)的不一致时,输出就显得「意外」。弄清你的假设,再把调试精力集中在验证这些假设是否真的成立上。
- 请教他人:你并不孤单。读不懂错误信息时,去问朋友、老师、搜索引擎或 AI 工具。讨论程序的过程中,能共享大量有价值的编程知识。
增量测试、模块化设计、精确假设与讨论交流——这些主题将贯穿本书,也希望它们伴随你的整个计算机科学生涯。
1.2 编程的基本要素
一门编程语言,绝不只是指挥计算机干活的手段。它还为我们提供了组织「计算过程之描述」的方式。程序的作用,在于在编程共同体成员之间交流这些思想。SICP 初版序言特别强调了这一点:「程序首先是写给人读的,顺带才让机器执行。」
在描述一门语言时,我们应特别留意它用何种手段,把简单的描述组合成更复杂的描述。每一门强大的语言都有三种这样的机制:
- 基本表达式与语句:语言所提供的最简单的构件;
- 组合手段:由较简单的元素构造出复合元素;
- 抽象手段:为复合元素命名,并将其作为单元来操作。
编程主要处理两类对象:函数与数据。(很快我们就会发现,二者其实并没有那么泾渭分明。)通俗地说,数据是我们想要操作的信息,而函数描述操作数据的具体步骤。因此,任何强大的编程语言都应既能描述数据与函数,又能提供用于组合、抽象二者的方法。
表达式
🎬 视频:Expressions
我们从简单之处入手,很快就会推向更有趣的例子。
基本表达式内部不含任何其他表达式。数字就是一种基本表达式——更确切地说,你输入的表达式由若干代表该数字的数字符号组成。
>>> 42
42
表示数字的表达式可以用数学运算符组合起来,构成复合表达式,解释器会对其求值:
>>> -1 - -10
9
>>> 1/2 + 1/4 + 1/8 + 1/16 + 1/32 + 1/64 + 1/128
0.9921875
Python 提供了许多构造复合表达式的方式。与其一上来就罗列殆尽,不如沿途逐一介绍新的表达式形式,以及支撑它们的语言特性。
调用表达式
🎬 视频:Functions, Objects, and Interpreters
最重要的一类复合表达式是调用表达式(call expression):它把某个函数作用于若干参数之上。在数学中,函数是从输入值到输出值的映射。类似地,在 Python 中,函数被施加于称为其实参(arguments,也译作参数)的输入值,执行若干计算,最后返回一个输出值,通常称为返回值(return value)。例如,max 函数把它的各个输入映射为单个输出——诸输入中的最大值。调用表达式的写法,与数学中的函数调用如出一辙。
>>> max(7.5, 9.5)
9.5
这个调用表达式含有子表达式:**运算符(operator)是位于圆括号之前的一个表达式,圆括号内则是以逗号分隔的操作数(operand)**表达式列表。[1]
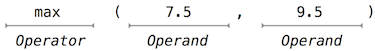
运算符求值为即将被调用的函数,每个操作数求值为一个实参。随后,函数被作用于这些实参。
调用表达式中实参的顺序至关重要。例如,pow 函数将第一个实参提升到第二个实参所给的幂次。
>>> pow(100, 2)
10000
>>> pow(2, 100)
1267650600228229401496703205376
相较于把 + 之类的运算符夹在两个表达式中间的数学惯例(即中缀记法),函数记法有三大优点。
其一,函数可以接受任意多个实参,而非只限于两个:
>>> max(1, -2, 3, -4)
3
其二,函数记法支持嵌套——其中的元素本身也是复合表达式。像 +、* 这样的运算符有一套必须先记住的运算优先级规则;而嵌套调用表达式的求值顺序,在层层括号之中已写得明明白白。
>>> max(min(1, -2), min(pow(3, 5), -4))
-2
在原则上,这种嵌套的深度,以及 Python 解释器所能求值的表达式整体复杂度,都没有上限。然而,再深的嵌套也转瞬就会把人绕晕。作为程序员,你的一个重要职责,就是组织好表达式,使它们始终能被你自己、你的编程伙伴,以及将来阅读这些表达式的其他人所理解。
其三,数学记法形态繁多:乘法藏在两项之间,指数化作上标,除法画成横线,平方根则像一顶斜檐的屋顶——其中不少字形极难输入!而把这些运算统统改写成调用表达式,既统一又便于键入,可谓一举两得。
导入库函数
Python 定义了大量函数,却并不默认把所有名字都摆在你面前。它把内置函数分门别类地收进模块(module),这些模块共同构成 Python 标准库。要使用其中的元素,先得导入它们。例如,math 模块提供了一系列我们耳熟能详的数学函数:
>>> from math import sqrt
>>> sqrt(256)
16.0
operator 模块则给出了与中缀运算符相对应的函数:
>>> from operator import add, sub, mul
>>> add(14, 28)
42
>>> sub(100, mul(7, add(8, 4)))
16
import 语句先指明模块名(如 operator 或 math),再列出要从该模块导入的具名属性(如 sqrt)。函数一旦导入,便可反复调用。
使用这些运算符函数(如 add)与直接使用运算符符号本身(如 +),二者并无区别。
Python 3 标准库文档逐一列出了各模块定义的函数,math 模块亦在其列。不过,这份文档是为通晓整门语言的开发者而写的。就眼下而言,你或许会发现:动手试一个函数,比读文档更能弄清它的脾气。等你渐渐熟悉了 Python 的语法与词汇,这份文档自会成为一座宝贵的参考资料库。
名称与环境
🎬 视频:Names, Assignment, and User-Defined Functions
编程语言的一项核心能力,是为值赋予名字。若某个值有了名字,我们就说该名字**绑定(binds)**到了这个值上。
在 Python 中,我们可以用**赋值语句(assignment statement)**建立新的绑定:等号 = 的左边是一个名字,右边是一个值:
>>> radius = 10
>>> radius
10
>>> 2 * radius
20
>>> radius
10
>>> diameter = 2 * radius
>>> diameter
20
名字也可以经由 import 语句而获得绑定。
>>> from math import pi
>>> pi * 71 / 223
1.0002380197528042
在 Python(以及许多其他语言)中,= 符号称为赋值运算符。赋值是我们最朴素的抽象手段:它让简单的名字可以指向复合表达式的计算结果,比如上面算出的 diameter。正是这样,复杂程序由一层层构造、复杂度层层递进的数据搭建起来。
名字既能绑定值、日后又能凭名字取回这些值,这就意味着解释器必须维护某种「记忆」,以追踪名字、值、绑定三者的关系。这份记忆称为环境(environment)。
名字也可以绑定到函数上。例如,max 这个名字就绑定在我们一直使用的 max 函数上。与数字不同,函数很难原样呈现为文本,因此当要求 Python 描述一个函数时,它会打印一段标识性的说明:
>>> max
<built-in function max>
我们可以用赋值语句为已有的函数另取新名:
>>> f = max
>>> f
<built-in function max>
>>> f(2, 3, 4)
4
而接连的赋值语句,可以将一个名字重新绑定到新的值上:
>>> f = 2
>>> f
2
在 Python 中,名字常被称作变量名或变量,因为在程序执行的过程中,它们可以绑定到不同的值。当某个名字通过赋值绑定到新值时,它便不再绑定于此前的任何值。你甚至可以把内置的名字重新绑定到新值上:
>>> max = 5
>>> max
5
把 max 赋值为 5 之后,名字 max 就不再绑定到函数了,此时若尝试调用 max(2, 3, 4),便会出错。
执行赋值语句时,Python 会先对 = 右边的表达式求值,再改变 = 左边名字的绑定。因此,你完全可以在右侧表达式中引用正要被这条赋值语句绑定的那个名字:
>>> x = 2
>>> x = x + 1
>>> x
3
我们还可以在一条语句中为多个名字赋予多个值:= 左侧的名字与右侧的表达式,均以逗号分隔。
>>> area, circumference = pi * radius * radius, 2 * pi * radius
>>> area
314.1592653589793
>>> circumference
62.83185307179586
改变一个名字的值,并不会影响其他名字。下面,尽管 area 当初是依据 radius 定义出来的,area 的值却并未随之改变。想更新 area 的值,得再写一条赋值语句。
>>> radius = 11
>>> area
314.1592653589793
>>> area = pi * radius * radius
>>> area
380.1327110843649
使用多重赋值时,= 右侧的所有表达式会先全部求值,然后才把左侧的名字依次绑定上去。有了这条规则,交换两个名字所绑定的值,一条语句即可完成:
>>> x, y = 3, 4.5
>>> y, x = x, y
>>> x
4.5
>>> y
3
求值嵌套表达式
表达式求值本身就是一个计算过程,可以描述为一串步骤。例如,在求值嵌套调用表达式时,解释器遵循如下流程:
- 先对运算符与操作数这些子表达式求值,然后
- 把运算符子表达式的值——即那个函数——作用于各操作数子表达式的值——即那些实参。
即便这样一条简单的流程,也揭示了关于「过程」的一般性要点。第一步规定:要完成一个调用表达式的求值过程,我们必须先求值其他表达式。可见,求值流程在本质上是递归的——它把「援引本规则自身」列为自己的一个步骤。
例如,求值
>>> mul(add(2, mul(4, 6)), add(3, 5))
208
需要把这一求值流程应用四次。倘若把每一个被求值的表达式都画出来,这一过程的层次结构便一目了然。
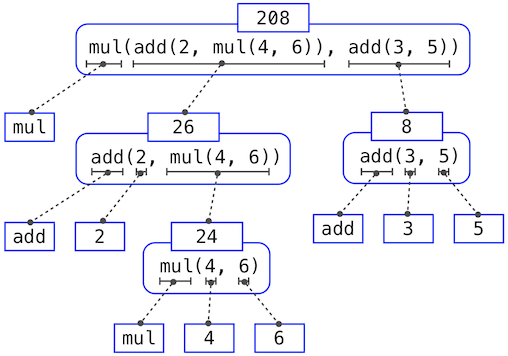
这张图称为表达式树(expression tree)。树中的每个位置,都是一个表达式连同它的值。
要求值位于最顶端的整个表达式,必须先求值它下方的子表达式。底部的表达式是基本表达式,求值结果要么是函数,要么是数字。以树的眼光看待求值,可以想象操作数的值自底向上「渗透」:从最底层的原始表达式出发,在越来越高的层级上逐级汇合。
接着请注意,第一步的反复施用,最终把我们带到这样一个境地:需要求值的不再是调用表达式,而是数字(如 2)和名字(如 add)这样的基本表达式。对于这些基本情形,我们这样规定:
- 数字求值为它所指称的那个数;[2]
- 一个(变量)名字,求值为当前环境中绑定到该名字的值。
请注意环境在确定表达式中符号取值时所扮演的重要角色。在 Python 中,脱离环境去谈论下面这个表达式的值,是没有意义的:
>>> add(x, 1)
因为没有任何信息指明环境会为名字 x(乃至名字 add)提供什么值。环境提供了求值赖以发生的语境,这对我们理解程序的执行至关重要。
这套求值流程并不足以求值所有 Python 代码——它只涵盖调用表达式、数字与名字。例如,它处理不了赋值语句。执行
>>> x = 3
既不返回值,也不把函数作用于任何实参,因为赋值的用意本就在于把名字绑定到值上。语句不求值,而是执行;它们不产生值,而是做出某种改变。每一类表达式或语句,都有各自的求值或执行流程。
纯函数与非纯函数
🎬 视频:Print and None
本书通篇都将区分两类函数。
纯函数
**纯函数(pure function)**接收输入(其实参),给出输出(施加于输入的结果),仅此而已。纯函数可以执行计算,而之所以称其为「纯」,是因为除了提供返回值之外,它对程序或计算机别无其他影响;并且,只要以相同的实参调用,它返回的值永远相同。
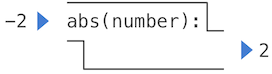
内置函数 abs 就是一例——它算得并返回其参数的绝对值。
>>> abs(-2)
2
可以把它描画成一台小机器:送入输入,送出输出。
非纯函数
非纯函数(non-pure function)除了返回值之外,还能产生副作用(side effects),对解释器或计算机的状态做出某种改变。一种常见的副作用,是在屏幕上产生输出,print 函数正是如此。
>>> print(1, 2, 3)
1 2 3
尽管在这些例子中 print 与 abs 看起来颇为相似,二者行事的方式却有着根本的不同。print 返回的值永远是 None——一个代表「空无一物」的 Python 特殊值。交互式 Python 解释器不会主动打印 None 这个值。对 print 而言,输出是它被调用时产生的副作用,是函数自己把东西打在了屏幕上。
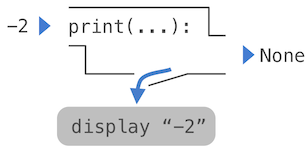
把返回值赋给一个名字,差别就显出来了:
>>> x = abs(-3)
>>> print(x)
3
>>> y = print(-3)
-3
>>> print(y)
None
由于 print 并不返回它的实参,调用 print 的结果也就无法参与到更复杂的表达式之中。例如,abs(-3) * 2 等于 6,因为 abs(-3) 返回 3;而 print(-3) * 2 会报错,因为 print(-3) 返回的是 None,而 None 无法与 2 相乘。
把对 print 的调用嵌套起来,是个颇堪玩味的例子。每次调用 print 都会显示一行;而对着 print 调用的返回值再调用 print,显示的便是 None。
>>> print(print(1), print(2))
1
2
None None
若你觉得这个输出出乎意料,不妨画一棵表达式树,弄清这个表达式为何会生出这般古怪的结果。
纯函数受到的限制在于:它不能有副作用,行为也不能随时间而改变。施加这些限制,收获颇为丰厚。其一,纯函数可以可靠地复合成复合调用表达式——我们已经看到,max、pow、sqrt 这类函数都能在嵌套表达式中用得得心应手。
纯函数还有其他好处:让复杂程序更易理解、更可预测,也让多个函数得以并发执行。
正因如此,本章余下部分,我们将着力于创建与使用纯函数。非纯函数留待第 2 章详加讨论。
注释
- 官方 Python 语言参考用另一套术语来描述调用表达式的各个部分:圆括号之前的表达式不叫运算符,而叫 primary(有时干脆就叫函数);圆括号内的表达式不叫操作数,而叫 argument expressions(实参表达式)。本书沿用更为经典的 operator / operand 之说,因为它们有助于区分表达式(属于代码)与值(属于数据)。↩
- 咬文嚼字地说,当我们断言某表达式求值为某值,实际意思是 Python 解释器把该表达式求值为该值。是解释器通过运行程序,赋予了这门编程语言以意义。既然解释器是一个行为始终如一的固定程序,那么在 Python 程序的语境下谈论表达式求值的结果,自然是顺理成章的事。↩
1.3 定义新函数
🎬 视频:Defining Functions
在 Python 中,我们已经识别出任何一门强大的编程语言都必须具备的若干要素:
- 数字与算术,是内置的基本数据值,以及函数或运算符;
- 嵌套的函数应用,提供了组合各种操作的手段;
- 把名字绑定到值,提供了一种有限的抽象手段。
现在,我们要学习函数定义——一种强大得多的抽象技术。凭借它,一个名字可以绑定到一项复合操作上,此后便可把这操作作为一个单元来引用。
我们先来考察如何表达「平方」这一观念。我们不妨说:「要平方某物,就把它自己乘自己。」在 Python 中,这就写成
>>> def square(x):
        return mul(x, x)
这定义了一个新函数,并给了它名字 square。这个用户自定义函数并非解释器内置的;它代表着「把某物乘以它自身」这一复合操作。定义中的 x 称为形式参数(formal parameter),它为「被乘的那个东西」提供了一个名字。这条定义创建了这个用户自定义函数,并将它绑定到名字 square 上。
def 语句
函数定义由一条 def 语句构成:它指明一个 <name>(名字)和一份以逗号分隔的具名 <formal parameters>(形式参数)列表;随后是一条 return 语句,称为函数体(function body),它指明函数的 <return expression>(返回表达式)——所谓返回表达式,就是函数每次被施加时要求值的那个表达式:
def <name>(<formal parameters>):
    return <return expression>
第二行必须缩进——多数程序员用四个空格缩进。返回表达式并不会立刻求值;它作为新定义函数的一部分被保存起来,只在函数最终被施加时才求值。
定义了 square 之后,便可用调用表达式来施加它:
>>> square(21)
441
>>> square(add(2, 5))
49
>>> square(square(3))
81
我们还可以把 square 当作积木,用来定义其他函数。例如,我们很容易定义 sum_squares:给定任意两个数作为实参,返回它们平方之和:
>>> def sum_squares(x, y):
        return add(square(x), square(y))
>>> sum_squares(3, 4)
25
用户自定义函数的使用方式,与内置函数完全一样。事实上,单从 sum_squares 的定义,根本看不出 square 究竟是解释器内置的、从模块导入的,还是用户自己定义的。
def 语句与赋值语句都把名字绑定到值上,任何已有的绑定都会因此失去。例如下面的 g,先指向一个无参函数,继而是一个数字,最后又变成另一个接受两个实参的函数。
>>> def g():
        return 1
>>> g()
1
>>> g = 2
>>> g
2
>>> def g(h, i):
        return h + i
>>> g(1, 2)
3
环境
🎬 视频:Environment Diagrams
我们眼下这个 Python 子集已经复杂到「程序的含义不再显而易见」的地步。倘若某个形式参数与某个内置函数同名,会怎样?两个函数可以共用一个名字而互不混淆吗?要解答这类问题,就必须更细致地描述环境。
表达式求值所在的环境,是一串帧(frames),通常画成一个个方框。每个帧包含若干绑定(bindings),每个绑定把一个名字与其对应的值关联起来。在一个帧内,同一个名字只能出现一次。全局有且仅有一个全局帧。赋值语句与 import 语句把条目加入当前环境的第一个帧。到目前为止,我们的环境只由全局帧构成。
📊 原文此处嵌入一个交互式环境图:
from math import pi; tau = 2 * pi。环境图展示了当前环境的绑定,以及各名字所绑定的值。本书原版的环境图可以按行单步执行,观察右侧环境状态的演变,也可点击链接载入 Online Python Tutor——那是 Philip Guo 为生成这类环境图而做的工具。建议你自拟例子,研读生成的环境图。
函数也会出现在环境图里。import 语句把名字绑定到内置函数;def 语句把名字绑定到由该定义所创建的用户自定义函数。导入 mul 并定义 square 之后的环境如下:
from operator import mul

def square(x):
    return mul(x, x)
📊 环境图中,每个函数画成一行,以
func打头,后面跟着函数名与形式参数。诸如mul这样的内置函数没有形式参数名,因此此处一律用...代替。
函数的名字出现了两次:一次在帧里,一次作为函数自身的一部分。函数自身携带的那个名字,称为内在名字(intrinsic name);帧中的那个名字,则是绑定名(bound name)。两个乃至更多不同的绑定名可以指向同一个函数,但函数自身只有一个内在名字,且永不改变。
求值时使用的,是帧中绑定到函数的那些名字;函数的内在名字在求值中不起作用。请用「前进」按钮单步走一遍下例,你会看到:一旦名字 max 绑定到值 3,它便再也不能充当函数了。
f = max
max = 3
result = f(2, 3, 4)
max(1, 2)   # 会引发错误
错误信息 TypeError: 'int' object is not callable 报告的是:名字 max(此时绑定到数字 3)是一个整数而非函数,因此不能充当调用表达式中的运算符。
函数签名(function signatures)。不同的函数,允许接受的实参个数也不同。为了记录这些要求,我们画每个函数时,都标出函数名及其形式参数。用户自定义函数 square 只接受 x;多给或少给实参都会出错。对函数形式参数的这种描述,称为该函数的签名。
函数 max 可以接受任意多个实参,因而不加区分地画作 max(...)。无论能接受几个实参,所有内置函数都画成 <name>(...),因为这些基本函数从未被显式定义过。
调用用户自定义函数
要求值一个运算符指向用户自定义函数的调用表达式,Python 解释器要遵循一套计算流程。与对待任何调用表达式一样,解释器先求值运算符与操作数表达式,再把具名函数作用于所得的各实参。
施加一个用户自定义函数,会引入第二个局部帧(local frame),它仅对该函数可见。把用户自定义函数施加于若干实参,其过程是:
- 在一个新的局部帧中,把各实参绑定到该函数的形式参数名上;
- 以这个帧为起点的环境中,执行该函数的函数体。
求值函数体所在的环境由两个帧构成:先是含有形式参数绑定的局部帧,然后是含有其他一切的全局帧。函数应用的每一个实例,都有其自己独立的局部帧。
为了讲清楚,下面把同一个例子的环境图分作几步来描绘。执行完第一条 import 语句后,全局帧中只绑定了名字 mul。
from operator import mul

def square(x):
    return mul(x, x)

square(-2)
📊 第 1 步:全局帧中
mul指向内置函数。
接着执行 square 函数的定义语句。请注意,整条 def 语句在一步之内处理完毕。函数的函数体并不执行——要等到函数被调用时才执行(定义时一概不动)。
📊 第 2 步:全局帧中新增
square,指向用户自定义函数func square(x) ...。
接下来,square 函数以实参 -2 被调用,于是新建一个帧,形式参数 x 在其中绑定到值 -2。
📊 第 3 步:新增局部帧
square(x),其中x绑定为 -2。
随后,在当前环境中查找名字 x——当前环境由图中所示的两个帧构成。两处 x 都求值为 -2,于是 square 函数返回 4。
📊 第 4 步:
square()帧中显示「Return value: 4」。
square() 帧里的「Return value」(返回值)并不是一条名字绑定,它表示的是:创建这个帧的那次函数调用所返回的值。
哪怕在这样简单的例子里,也用到了两个不同的环境。顶层表达式 square(-2) 在全局环境中求值;返回表达式 mul(x, x) 则在调用 square 所创建的环境中求值。x 与 mul 都在这个环境中有着落,只不过分属不同的帧。
环境中各帧的次序,会影响在表达式中查找名字所得的取值。我们先前说过,名字求值为当前环境中与该名字关联的值。现在可以讲得更精确些:
名字求值规则。 一个名字求值为:在当前环境中找到该名字的最早那个帧里,绑定在该名字上的值。(这里的「最早」,指检查帧的先后顺序,从正被调用的函数的局部帧开始。)
之所以要设多个帧,是为了让同一个名字在不同语境下可以有不同的含义。英语这样的自然语言也有此性质:在覆盖千万观众的美国新闻报道中,「president」指的是美国总统——那是一个宽泛的全球语境;而在某个学生社团的成员会议上,「president」指的则是该社团的社长——那是一个本土得多的语境。在社团会议里,取用的是「president」更贴近局部的含义,而非更全球化的那层意思。
这种名字求值方式意味着:函数体内(def 语句被缩进的代码段)使用的名字,会优先取用该函数内的形式参数与赋值语句,其次才轮到全局名字。若同一名字在局部帧与全局帧中都出现,我们就说局部名字**遮蔽(shadows)**了全局名字。
我们这套关于环境、名字与函数的概念框架,构成一个求值模型(model of evaluation)——它精确而正确地描述了解释器如何求值调用表达式。称之为「模型」,是因为它略去了一些细节,比如计算机内存是如何组织的。那些细节对速度优化至关重要,但对理解程序的行为却无关宏旨。
示例:调用一个用户自定义函数
让我们再次审视那两个简单的函数定义,并描绘求值一个用户自定义函数调用表达式的过程。
from operator import add, mul

def square(x):
    return mul(x, x)

def sum_squares(x, y):
    return add(square(x), square(y))

result = sum_squares(5, 12)
Python 首先求值名字 sum_squares,它在全局帧中绑定到一个用户自定义函数。基本数值表达式 5 与 12 求值为它们所代表的数。
接下来,Python 施加 sum_squares,引入一个局部帧,把 x 绑定为 5、y 绑定为 12。
sum_squares 的函数体包含如下调用表达式:
add       (  square(x)  ,  square(y)  )
________     _________     _________
运算符       操作数 0       操作数 1
三个子表达式都在当前环境中求值,而当前环境以标着 sum_squares() 的帧为起点。运算符子表达式 add 是从全局帧中找到的名字,绑定着做加法的内置函数。两个操作数子表达式必须依次求值,然后才能施加加法。两个操作数都在以 sum_squares 帧为起点的当前环境中求值。
在操作数 0 中,square 指的是全局帧里的一个用户自定义函数,而 x 指的是局部帧里的数字 5。Python 把 square 施加于 5,为此又引入一个局部帧,把 x 绑定为 5。
借助这个环境,表达式 mul(x, x) 求值为 25。
求值流程随即转向操作数 1,这里的 y 指的是数字 12。Python 再次求值 square 的函数体,这次又引入一个局部帧,把 x 绑定为 12。于是操作数 1 求值为 144。
最后,把加法施加于实参 25 与 144,得到 sum_squares 的最终返回值:169。
这个例子体现了我们至今建立的许多基本观念。名字绑定到值,这些值散布在许多相互独立的局部帧中,再加上一个含有共享名字的全局帧。每当函数被调用,就引入一个新的局部帧——哪怕调用的是同一个函数两次,也不例外。
所有这些机制,都是为了保证在程序执行的过程中,名字能在恰当的时刻解析到恰当的值上。这个例子也说明,我们的模型为何必须具备这些复杂性:三个局部帧里都含有名字 x 的绑定,但在不同的帧中,该名字绑定着不同的值。正是局部帧把同名者隔离开来。
局部名字
函数实现中有一个细节,不应当影响函数的行为,那就是实现者为形式参数所选的名字。因此,下面两个函数应当表现出相同的行为:
>>> def square(x):
        return mul(x, x)
>>> def square(y):
        return mul(y, y)
这条原则——函数的含义应当独立于其作者所选的参数名——有几项重要推论。例如,函数的参数名只在函数体内部指称其实参;它们是函数**局部(local)**的。
倘若参数不是各自函数体的局部名字,那么 square 里的参数 x 就可能与 sum_squares 里的参数 x 混淆。关键在于:这种混淆并不会发生——不同局部帧中 x 的绑定互不相干。语言的种种设计,正是为了保证这种独立性。
我们说,一个局部名字的**作用域(scope)限于定义它的那个用户自定义函数的函数体。当一个名字不再可被访问时,它就超出作用域(out of scope)**了。这种作用域行为并非我们模型之外的新事实,它正是环境运作方式的必然结果。
作用域与环境是什么关系?作用域关乎代码:它描述名字在代码的何处可用——例如,函数的参数名可用在函数体内,出了函数体便不可用。环境关乎代码的求值:它在程序运行时追踪名字与值之间的绑定。二者之所以相关,是因为「如何创建与使用不同环境」的规则,保证了作用域内的名字总在当前环境中,而作用域外的名字则不在。
选择名字
名字可以互换,并不意味着形式参数名就无足轻重。恰恰相反,精心挑选的函数名与参数名,对于函数定义能否被人读懂至关重要!
以下准则改编自 Python 代码风格指南(PEP 8),这份指南是全体(不那么叛逆的)Python 程序员的共同守则。一套共享的约定,能让开发者共同体内部的交流更为顺畅。遵循这些约定,还有一个附带的好处:你会发现自己的代码在内部愈发自洽。
- 函数名用小写,单词之间用下划线分隔;提倡使用描述性的名字。
- 函数名通常应当唤起「解释器对实参所做的操作」(如
print、add、square),或者「结果所得的那个量」(如max、abs、sum)。 - 参数名用小写,单词之间用下划线分隔;优先使用单个单词。
- 参数名应当唤起该参数在函数中的角色,而不只是所允许的实参类型。
- 当角色一目了然时,单字母参数名可以接受;但要避开
l(小写 L)、O(大写 O)、I(大写 I),以免与数字混淆。
这些准则有许多例外,即便在 Python 标准库里也不例外。如同英语的词汇,Python 也从形形色色的贡献者那里继承了词语,结果未必总是整齐划一。
函数即抽象
尽管十分简单,sum_squares 却体现了用户自定义函数最强大的性质。sum_squares 是依据函数 square 定义的,但它只倚赖 square 所定义的「输入实参与输出值之间的关系」,而不问其内部如何运作。
我们写 sum_squares 时,根本不必操心「如何平方一个数」。阅读 sum_squares 的函数体时,可以完全忽略平方是如何算出来的。事实上,对 sum_squares 而言,square 并不是某个特定的函数体,而是对函数的抽象——一种所谓的函数抽象(functional abstraction)。它可以靠乘法来平方,也可以靠反复相加来平方,或者先乘再加。任何能算出平方的函数,都同样合格。
因此,只看返回值的话,下面两个平方函数应当无从分辨。二者各接受一个数值实参,并以该数的平方作为返回值。
>>> def square(x):
        return mul(x, x)
>>> def square(x):
        return mul(x, x-1) + x
换言之,函数定义为「输入与输出之间的某种关系」赋予了一个名字,而把细节抽象掉了。函数的使用者未必亲手写过这个函数,甚至可能根本不知道它是怎么实现的。程序员使用一个函数时,本不该需要了解它的实现方式。Python 库正具备这一性质:无数开发者使用其中定义的函数,却很少有人去翻看实现。这就是抽象的威力。
函数抽象的诸方面。 要掌握一种函数抽象,常常需要考察它的三大核心属性。函数的**定义域(domain)**是它能接受的实参集合;**值域(range)**是它能返回的值集合;意图(intent)或行为则是它所计算的输入与输出之间的关系(以及可能产生的任何副作用)。通过定义域、值域与意图来理解函数抽象,是在复杂程序中正确使用它们的关键。
例如,用来实现 sum_squares 的任何平方函数,都应具备如下属性:
- 定义域:任意单个实数;
- 值域:任意非负实数;
- 意图:输出为输入的平方。
这些属性并未规定意图如何实现;实现细节已被抽象掉了。
运算符
🎬 视频:Operators and Division
数学运算符(如 +、-)提供了我们关于「组合手段」的第一个例子,但我们尚未为含有这些运算符的表达式定义求值流程。
含中缀运算符的 Python 表达式各有自己的求值流程,不过你大可以把它们视为调用表达式的简写。当你看到
>>> 2 + 3
5
不妨就把它当成下面这行的简写:
>>> add(2, 3)
5
中缀记法可以嵌套,一如调用表达式。Python 遵循通常的数学运算优先级规则,这些规则决定了含有多个运算符的复合表达式该如何解读。
>>> 2 + 3 * 4 + 5
19
求值结果与下面这行相同:
>>> add(add(2, mul(3, 4)), 5)
19
调用表达式中的嵌套比运算符版本更为显式,但也更难读。Python 允许用圆括号对子表达式分组,以覆盖常规的优先级规则,或让表达式的嵌套结构更清晰。
>>> (2 + 3) * (4 + 5)
45
求值结果与下面这行相同:
>>> mul(add(2, 3), add(4, 5))
45
说到除法,Python 提供了两个中缀运算符:/ 与 //。前者是普通除法,结果总是浮点数(小数),即便除尽也是如此:
>>> 5 / 4
1.25
>>> 8 / 4
2.0
后者 // 则把结果向下取整为整数:
>>> 5 // 4
1
>>> -5 // 4
-2
这两个运算符分别是 truediv 与 floordiv 函数的简写。
>>> from operator import truediv, floordiv
>>> truediv(5, 4)
1.25
>>> floordiv(5, 4)
1
在你的程序中,尽可放心大胆地使用中缀运算符与圆括号。对于简单的数学运算,地道的 Python 偏爱运算符,而非调用表达式。
译者注:原文中的若干「环境图」是可交互的 Web 组件(点击即可逐步演示),静态文档无法承载,已改写为对应的程序片段与分步说明。
1.4 设计函数
🎬 视频:Designing Functions
函数是一切程序的必要成分,无论程序大小;它也是我们在编程语言中表达计算过程的主要媒介。至此,我们讨论的都是函数的形式性质以及如何施加它们。现在,我们转而讨论:什么样的函数才算好的函数。从根本上说,好函数的各项品质,都在强化「函数即抽象」这一理念。
- 每个函数只应承担一件事。 这件事应当能用简短的名字指认,并用一行文字概述。凡按序承担多件事的函数,都应当拆成多个函数。
- 不要重复自己(Don't repeat yourself),这是软件工程的一条核心信条。所谓的 DRY 原则指出:多段代码不应当重复描述同一逻辑;那逻辑应当只实现一次,给它一个名字,然后反复施加。当你发现自己在一段段地复制粘贴代码时,多半是遇到了做函数抽象的好机会。
- 函数应当定义得尽量一般(general)。 Python 库中之所以没有「平方」函数,恰恰因为它只是
pow函数的一个特例——而pow能把数提升到任意幂次。
这些准则能提高代码的可读性、减少错误,而且往往能减少总的代码量。把复杂任务分解为简洁的函数,是一门需要经验才能掌握的技艺。所幸,Python 提供了若干特性来助你一臂之力。
文档
函数定义中往往包含描述该函数的文档(documentation),称为文档字符串(docstring),它必须与函数体一同缩进。按照惯例,文档字符串使用三引号。第一行用一句话描述该函数的职责;随后的行可以说明各个参数,并澄清函数的行为:
>>> def pressure(v, t, n):
        """Compute the pressure in pascals of an ideal gas.

        Applies the ideal gas law: https://en.wikipedia.org/wiki/Ideal_gas_law

        v -- volume of gas, in cubic meters
        t -- absolute temperature in degrees kelvin
        n -- particles of gas
        """
        k = 1.38e-23  # Boltzmann's constant
        return n * k * t / v
当你以函数名作为实参调用 help 时,便会看到它的文档字符串(输入 q 可退出 Python 帮助):
>>> help(pressure)
编写 Python 程序时,除最简单的函数外,都应写上文档字符串。请记住:代码只写一次,却常常被读很多次。Python 官方文档中载有文档字符串的撰写指南,它能让不同的 Python 项目保持一致。
注释。 Python 中的注释可以附在一行末尾,以 # 号引出。例如,上面那条 # Boltzmann's constant 注释就在说明 k。这类注释不会出现在 Python 的帮助信息中,解释器也对它视而不见——它们只为人类而存在。
默认参数值
把函数定义得一般化,随之而来的副产品是参数数量的增加。参数一多,函数调用起来别扭,读起来也费劲。
在 Python 中,我们可以为函数的参数提供默认值(default values)。调用该函数时,带默认值的参数就是可选的;若未提供,则把默认值绑定到对应的形式参数名上。例如,若某个应用常常要算一摩尔粒子的压强,就可以把这个值设为默认值:
>>> def pressure(v, t, n=6.022e23):
        """Compute the pressure in pascals of an ideal gas.

        v -- volume of gas, in cubic meters
        t -- absolute temperature in degrees kelvin
        n -- particles of gas (default: one mole)
        """
        k = 1.38e-23  # Boltzmann's constant
        return n * k * t / v
在这个例子里,= 符号依用法的不同而有两种含义。在 def 语句的头部,= 并不执行赋值,而是指明调用 pressure 函数时若无对应实参则采用的默认值。相比之下,函数体中给 k 的那条赋值语句,把名字 k 绑定到玻尔兹曼常数的一个近似值上。
>>> pressure(1, 273.15)
2269.974834
>>> pressure(1, 273.15, 3 * 6.022e23)
6809.924502
pressure 函数定义为接受三个参数,但上面第一个调用表达式只提供了两个。此时,n 的取值来自 def 语句中的默认值。若提供了第三个实参,默认值便被忽略。
作为一条准则:函数体中使用的多数数据值,都应当写成具名参数的默认值,以便检查,也便于调用者修改。有些永不改变的值,比如基本常数 k,则可以在函数体中或全局帧中绑定。
1.5 控制
🎬 视频:Conditional Statements、Iteration(详见下文)
我们已经能定义的那些函数,表达能力还十分有限——因为尚未引入比较的手段,也无法根据比较的结果执行不同的操作。**控制语句(control statements)**赋予我们这种能力。它们依据逻辑比较的结果,来控制程序执行的流向。
控制语句与我们此前研究的表达式有所不同。它们不像表达式那样有一个值;相反,执行一条控制语句,决定的是解释器接下来该做什么。
语句
我们已经见过三类语句:赋值语句、def 语句和 return 语句。这几行 Python 代码本身并不是表达式——尽管它们都以表达式作为组成部分。
语句不求值,而是执行。每条语句都描述了某种对解释器状态的改变,执行一条语句就是施行这种改变。正如在 return 与赋值语句中所见,执行语句往往涉及求值其中所含的子表达式。
函数的函数体是一串语句。在 Python 中,一个表达式可以单独占一行,此时它被当作语句处理,称为表达式语句(expression statement),其值则被丢弃。
例如,下面把 return 关键字漏掉之后,mul(x, x) 就成了一条表达式语句:x 确实乘了自己,但结果被丢弃,而没有返回。
>>> def square(x):
        mul(x, x) # 当心!这个调用不返回值。
>>> print(square(3))
None
>>> y = square(4)
>>> print(y)
None
要想利用某个表达式的值做点什么,它必须成为某条更大语句的一部分,比如赋值语句或 return 语句。
>>> def square(x):
        return mul(x, x)
>>> print(square(3))
9
>>> y = square(4)
>>> print(y)
16
有时,当函数体调用的是 print 这样的非纯函数时,让函数体只含一个表达式也确实说得过去。然而,用 print 显示一个值,并不等于返回它;那个值也就无法再被赋值,或进一步参与组合。
>>> def print_square(x):
        print(mul(x, x))
>>> print_square(3)
9
>>> y = print_square(4)
16
>>> print(y)
None
Python 解释器的职责是执行程序,而程序是语句的序列。不过,计算中许多有趣的工作,恰恰来自表达式的求值。语句控制着:程序中有哪些表达式被求值、它们在什么环境中求值,以及它们的结果何去何从。
复合语句
**简单语句(simple statement)**是不以冒号结尾的单独一行。复合语句(compound statement)之所以这么叫,是因为它由其他语句(简单语句与复合语句皆可)复合而成。复合语句通常跨越多行,以一个以冒号结尾的单行头部(header)开始,由此标明语句的类型。头部连同其后缩进的一组语句,合称一个子句(clause)。一条复合语句由一个或多个子句构成:
<header>:
    <statement>
    <statement>
    ...
<separating header>:
    <statement>
    <statement>
    ...
用这套术语来理解,我们已经介绍的语句便可归位:
- 表达式语句、return 语句和赋值语句,都是简单语句;
- def 语句是复合语句,def 头部之后的那组语句定义了函数体。
每一类头部都有各自专门的求值规则,规定其子句组中的语句何时执行、是否执行。我们说,头部**控制(controls)**着它的子句组。例如在 def 语句中,我们看到返回表达式并不立即求值,而是被保存起来,留待所定义的函数最终被调用时使用。
现在我们也能理解多行程序了:
- 要执行一串语句,先执行第一条。若该语句没有重定向控制,就继续执行这串语句的其余部分(若还有剩余)。
这个定义揭示了递归定义的序列之本质结构:一个序列可以分解为它的第一项与其余各项。而一串语句的「其余部分」,本身又是一串语句!于是,我们可以递归地施用这条执行规则。
这条规则的重要推论是:语句按序执行,但若控制被重定向,后面的语句可能永远也执行不到。
实用建议。 为子句组缩进时,所有行必须缩进相同的量、相同的方式(用空格,不要用制表符)。缩进上任何不一致都会导致错误。
局部赋值
起初,我们说用户自定义函数的函数体只包含一条 return 语句、一个返回表达式。事实上,函数可以定义一序列操作,远远超出单个表达式的范围。
每当用户自定义函数被施加,其定义的子句组序列就会在这样一个环境中执行:该环境以一个局部帧为起点,而此帧正是由调用该函数所创建的。return 语句会重定向控制:函数应用的过程一旦执行到第一条 return 语句便告结束,该返回表达式的值,就是被施加函数的返回值。
赋值语句可以出现在函数体内部。例如,下面这个函数用两步计算,返回两个量之差相对于第一个量的百分比:
def percent_difference(x, y):
    difference = abs(x-y)
    return 100 * difference / x

result = percent_difference(40, 50)
赋值语句的作用,是在当前环境的第一个帧中把名字绑定到值上。因此,函数体内的赋值语句无法影响全局帧。函数只能操作自己的局部帧,这一点极大地简化了编程——纯函数只通过所取的值和所返回的值发生交互,而不去影响其他函数的行为。
当然,percent_difference 也可以写成一个表达式,如下所示——只不过返回表达式要复杂些:
>>> def percent_difference(x, y):
        return 100 * abs(x-y) / x
>>> percent_difference(40, 50)
25.0
至此,局部赋值尚未增强我们函数定义的表达能力。它与别的控制语句结合时才会大显身手;但即便单用,它也颇有用处——通过为中间量赋予名字,能让复杂表达式的含义更清晰。
条件语句
🎬 视频:Conditional Statements
Python 有一个计算绝对值的内置函数。
>>> abs(-2)
2
我们想自己实现这样一个函数,但这样做需要比较与选择。我们想表达的是:若 x 为负,abs(x) 返回 -x;若 x 为 0,abs(x) 返回 0;否则 x 为正,abs(x) 返回 x。在 Python 中,这种选择可以用**条件语句(conditional statement)**来表达。
def absolute_value(x):
    """Compute abs(x)."""
    if x < 0:
        return -x
    elif x == 0:
        return 0
    else:
        return x

result = absolute_value(-2)
Python 的条件语句由一系列头部与子句组构成:一个必需的 if 子句、若干可选的 elif 子句,最后是一个可选的 else 子句:
if <expression>:
    <suite>
elif <expression>:
    <suite>
else:
    <suite>
执行条件语句时,各子句按序逐一考察。执行一个条件子句的计算流程如下:
- 求值头部的表达式;
- 若为真值,执行该子句组,然后跳过条件语句中其后所有的子句。
若执行到了 else 子句(只有当前面所有 if 与 elif 的表达式都求值为假值时才可能),则执行它的子句组。
布尔值与布尔运算符
布尔语境(boolean contexts)。 上面的执行流程提到了「假值」与「真值」。条件块头部语句中的表达式,据说处于布尔语境之中:它们的真值关乎控制流,除此之外,它们的值既不被赋值,也不被返回。Python 中有若干假值,包括 0、None,以及布尔值 False。其他所有数字都是真值。在第 2 章中我们会看到,Python 中每一种内置数据类型都兼有真值与假值。
布尔值。 Python 有两个布尔值,True 与 False。布尔值表示逻辑表达式里的真值。内置的比较运算 >、<、>=、<=、==、!= 就返回这两个值。
>>> 4 < 2
False
>>> 5 >= 5
True
第二个例子读作「5 大于或等于 5」,对应于 operator 模块中的函数 ge。
>>> 0 == -0
True
最后一个例子读作「0 等于 -0」,对应于 operator 模块中的 eq。请注意,Python 把赋值(=)与相等比较(==)区分开来——这是许多编程语言共有的约定。
布尔运算符。 Python 还内置了三个基本的逻辑运算符:
>>> True and False
False
>>> True or False
True
>>> not False
True
逻辑表达式各有相应的求值流程。这些流程利用了一个事实:逻辑表达式的真值,有时无需求值全部子表达式便可确定——这一特性称为短路求值(short-circuiting)。
要求值表达式 <left> and <right>:
- 求值子表达式
<left>; - 若结果为假值 v,则该表达式求值为 v;
- 否则,该表达式求值为子表达式
<right>的值。
要求值表达式 <left> or <right>:
- 求值子表达式
<left>; - 若结果为真值 v,则该表达式求值为 v;
- 否则,该表达式求值为子表达式
<right>的值。
要求值表达式 not <exp>:
- 求值
<exp>;若结果为假值则得True,否则得False。
这些值、规则与运算符,赋予我们组合比较结果的手段。执行比较、返回布尔值的函数,其名字通常以 is 开头,且后面不接下划线(如 isfinite、isdigit、isinstance 等)。
迭代
🎬 视频:Iteration
控制语句除了用来选择执行哪些语句,还用来表达重复。如果我们写的每一行代码都只执行一次,那么编程将是一门极低效的营生。唯有反复执行语句,才能充分释放计算机的潜力。我们已经见过一种重复的形式:一个函数只定义一次,却能被调用许多次。而迭代控制结构,则是反复执行同样语句的另一种机制。
考察斐波那契数列,其中每个数都是前两个数之和:
0, 1, 1, 2, 3, 5, 8, 13, 21, ...
其中的每个值,都是反复施用「前两数相加」的规则构造出来的。第 0 个与第 1 个固定为 0 和 1,因此 1 是第二项。例如,第八个斐波那契数是 21。
我们可以用 while 语句计算第 n 个斐波那契数。需要追踪:算到了哪个位置(k)、第 k 个值(curr)以及它的前一个值(pred)。请单步执行下面的函数,观察斐波那契数是如何一个个演进、并绑定到 curr 上的。
def fib(n):
    """Compute the nth Fibonacci number, for n >= 1."""
    pred, curr = 0, 1   # 第 0 个与第 1 个斐波那契数
    k = 1               # curr 是第几个斐波那契数?
    while k < n:
        pred, curr = curr, pred + curr
        k = k + 1
    return curr

result = fib(8)
请记住,赋值语句中用逗号分隔多个名字与多个值。这一行:
pred, curr = curr, pred + curr
的效果是:把名字 pred 重新绑定到 curr 的值,同时把 curr 重新绑定到 pred + curr 的值。= 右侧的所有表达式,都在任何重新绑定发生之前求值完毕。
这种顺序——先求值 = 右边的一切,再更新左边的任何绑定——对保证这个函数的正确性至关重要。
一个 while 子句包含一个头部表达式,随后是一个子句组:
while <expression>:
    <suite>
要执行一个 while 子句:
- 求值头部的表达式;
- 若为真值,执行子句组,然后回到第 1 步。
在第 2 步中,while 子句的整个子句组执行完毕,头部表达式才会被再次求值。
为了防止 while 子句的子句组无休无止地执行下去,子句组在每一轮中都应改变某个绑定。
不终止的 while 语句称为无限循环(infinite loop)。按 <Control>-C 可迫使 Python 停止循环。
测试
**测试(testing)**一个函数,就是验证该函数的行为是否与预期相符。我们这门函数语言如今已足够复杂,是时候开始测试自己的实现了。
**测试(test)**是系统化地执行这种验证的机制。测试通常采取另一个函数的形式,其中包含一处或多处对待测函数的示例调用,再把返回值与预期结果加以核对。与大多数力求通用的函数不同,测试要选取具体的实参值来调用并验证。测试同时也是一份文档:它演示了如何调用一个函数,以及什么样的实参值才算恰当。
断言
程序员用 assert 语句来验证预期,比如被测试函数的输出。assert 语句含有一个处于布尔语境中的表达式,随后是一行带引号的文本(单引号双引号皆可,但要前后一致);若该表达式求值为假值,这行文本就会显示出来。
>>> assert fib(8) == 21, 'The 8th Fibonacci number should be 21'
当被断言的表达式求值为真值时,执行 assert 语句毫无效果;而若为假值,assert 会引发错误,中止执行。
fib 的测试函数应当测试若干实参,包括 n 的极端取值。
>>> def fib_test():
        assert fib(1) == 1, 'The 1st Fibonacci number should be 1'
        assert fib(3) == 2, 'The 3rd Fibonacci number should be 2'
        assert fib(50) == 12586269025, 'Error at the 50th Fibonacci number'
在文件中写 Python 时(而非直接敲进解释器),测试通常写在同一个文件中,或写在后缀为 _test.py 的相邻文件里。
文档测试
Python 提供了一种便利的做法:把简单的测试直接放进函数的文档字符串。文档字符串的第一行应是一句话的函数描述,随后空一行,再往后可以详细描述参数与行为。此外,文档字符串还可以包含一段调用该函数的示例交互会话:
>>> def sum_naturals(n):
        """Return the sum of the first n natural numbers.

        >>> sum_naturals(10)
        55
        >>> sum_naturals(100)
        5050
        """
        total, k = 0, 1
        while k <= n:
            total = total + k
            k = k + 1
        return total
随后,可以借助 doctest 模块来验证这段交互:
>>> from doctest import testmod
>>> testmod()
TestResults(failed=0, attempted=2)
若只想验证单个函数的文档测试交互,我们使用 doctest 中一个名为 run_docstring_examples 的函数。遗憾的是,这个函数的调用方式略嫌繁琐:第一个实参是要测试的函数;第二个永远应当是表达式 globals() 的结果——这是个内置函数,返回全局环境;第三个实参为 True,表示希望得到「啰嗦」的输出,即列出所有运行过的测试。
>>> from doctest import run_docstring_examples
>>> run_docstring_examples(sum_naturals, globals(), True)
Finding tests in NoName
Trying:
    sum_naturals(10)
Expecting:
    55
ok
Trying:
    sum_naturals(100)
Expecting:
    5050
ok
当函数的返回值与预期结果不符时,run_docstring_examples 会把这一问题报告为测试失败。
在文件中写 Python 时,可以用 doctest 命令行选项启动 Python,一次性运行文件中的所有文档测试:
python3 -m doctest <python_source_file>
有效测试的关键,是在实现新函数之后立即编写(并运行)测试。更好的习惯是:在动手实现之前就先写一些测试,好让心中先有几个示例输入与输出。只施加单个函数的测试称为单元测试(unit test)。彻底的单元测试,是优秀程序设计的一块试金石。
译者注:1.4 与 1.5 原文中的交互式环境图,同样改写为程序片段与文字说明。
1.6 高阶函数
🎬 视频:Higher-Order Functions
我们已经看到,函数描述的是复合操作,而不依赖其实参的具体取值。也就是说,在 square 中
>>> def square(x):
        return x * x
我们谈论的并不是某个特定数的平方,而是求得任意数平方的方法。当然,即使从不定义这个函数,只消一直写下
>>> 3 * 3
9
>>> 5 * 5
25
而从不明确提起 square,日子照样能过。这种做法应付得了 square 这样简单的计算,但遇上 abs、fib 之类更复杂的例子,就变得苦不堪言了。总的来说,缺少函数定义,我们就始终被迫停留在「语言恰好内置了哪些具体操作」的层面(此处是乘法),而无法凭借函数抽象来思考。程序固然能算出平方,语言却无从表达「平方」这个概念。
我们对一门强大的编程语言的要求之一,是能够通过「为常见模式赋予名字,再直接按名字操作」来建立抽象。函数正提供了这种能力。从下面的例子中我们会看到,有些常见的编程模式反复出现于代码之中,只是所配的函数各不相同。这些模式同样可以被抽象出来,办法同样是给它们起名字。
要把某些一般模式表达为具名的概念,我们需要构造这样的函数:它能接受其他函数作为实参,或者把函数作为返回值。操作函数的函数,称为高阶函数(higher-order functions)。本节将展示,高阶函数如何充当强大的抽象机制,从而极大增强我们语言的表达能力。
函数作为实参
考察下面三个函数,它们都在计算求和。第一个 sum_naturals 求自然数之和,直加到 n:
>>> def sum_naturals(n):
        total, k = 0, 1
        while k <= n:
            total = total + k
            k = k + 1
        return total
>>> sum_naturals(100)
5050
第二个 sum_cubes 求自然数立方之和,直加到 n:
>>> def sum_cubes(n):
        total, k = 0, 1
        while k <= n:
            total = total + k * k * k
            k = k + 1
        return total
>>> sum_cubes(100)
25502500
第三个 pi_sum 求下列级数之和:
8/(1·3) + 8/(5·7) + 8/(9·11) + …
该级数收敛于 π(收敛得非常慢)。
>>> def pi_sum(n):
        total, k = 0, 1
        while k <= n:
            total = total + 8 / ((4*k-3) * (4*k-1))
            k = k + 1
        return total
>>> pi_sum(100)
3.1365926848388144
这三个函数显然共享着一个底层的共同模式。它们大体上一模一样,只在名字,以及「用 k 计算待加项的那个表达式」上有所不同。把同一个模板里留空的地方填上,就能生成这三个函数:
def <name>(n):
    total, k = 0, 1
    while k <= n:
        total = total + <term>(k)
        k = k + 1
    return total
这样一个共同模式的存在,强有力地表明:有一种有用的抽象正等着被请到台面上来。这三个函数,无非都是「若干项之和」。作为程序设计者,我们希望语言足够强大,能写出表达「求和」这个概念本身的函数,而不只是算出某个具体和的函数。在 Python 中,把上面那个公共模板里的「空位」变成形式参数,便可轻而易举地做到这一点。
在下面的例子中,summation 接受两个实参:上界 n,以及计算第 k 项的函数 term。我们可以像使用任何函数那样使用 summation,它能简洁地表达求和。请花些时间单步走一遍这个例子,注意:把 cube 绑定到局部名字 term 之后,结果 1×1×1 + 2×2×2 + 3×3×3 = 36 是如何被正确算出的。在这个例子里,不再需要的帧已被移除,以节省空间。
def summation(n, term):
    total, k = 0, 1
    while k <= n:
        total = total + term(k)
        k = k + 1
    return total

def cube(x):
    return x*x*x

def sum_cubes(n):
    return summation(n, cube)

result = sum_cubes(3)
借助一个返回其自身实参的恒等函数(identity function),我们还能用同一个 summation 函数来做自然数求和:
>>> def summation(n, term):
        total, k = 0, 1
        while k <= n:
            total = total + term(k)
            k = k + 1
        return total
>>> def identity(x):
        return x
>>> def sum_naturals(n):
        return summation(n, identity)
>>> sum_naturals(10)
55
summation 函数也可以直接调用,不必为某个特定数列另写一个函数。
>>> summation(10, square)
385
借助我们这套求和抽象,再定义一个计算各项的函数 pi_term,便能写出 pi_sum。我们传入实参 1e6——那是 1 × 10⁶ = 1000000 的简写——以得到一个足够逼近 π 的近似值。
>>> def pi_term(x):
        return 8 / ((4*x-3) * (4*x-1))
>>> def pi_sum(n):
        return summation(n, pi_term)
>>> pi_sum(1e6)
3.141592153589902
函数作为一般方法
我们引入用户自定义函数,是为了把数值运算的模式抽象出来,使之脱离具体数字而独立。有了高阶函数,我们开始看到一种更强大的抽象:某些函数表达的是一般的计算方法,独立于它们所调用的具体函数。
尽管「函数」这一概念在观念上被如此拓展,我们那套用来求值调用表达式的环境模型,却能优雅地延展到高阶函数的情形,无需任何改动。当用户自定义函数被施加于若干实参时,形式参数就在一个新的局部帧中绑定到那些实参的值上(这些值可以是函数)。
考察下面这个例子:它实现了一种通用的**迭代改进(iterative improvement)**方法,并用它来计算黄金比例。黄金比例常被称为「phi」或 φ,是一个接近 1.6 的数,频频现身于自然、艺术与建筑之中。它恰是一个比自己的倒数多 1 的数:φ = 1 + 1/φ。
迭代改进算法先给出方程解的一个猜测值,然后反复施加一个**更新函数(update function)**来改进这个猜测,再施加一次「接近比较」,检查当前的猜测是否「足够接近」而可视为正确。
>>> def improve(update, close, guess=1):
        while not close(guess):
            guess = update(guess)
        return guess
这个 improve 函数是对「反复精炼」的一般表达。它并未规定求解的是什么问题——那些细节,都留给作为实参传入的 update 与 close 函数了。
黄金比例有几条著名性质:它可以由「反复把任意正数的倒数与 1 相加」算出;它比自己的平方小 1。我们可以把这些性质表达成函数,供 improve 使用。
>>> def golden_update(guess):
        return 1/guess + 1
>>> def square_close_to_successor(guess):
        return approx_eq(guess * guess, guess + 1)
上面我们引入了一处对 approx_eq 的调用,其用意是:若两个实参彼此近似相等,就返回 True。要实现 approx_eq,可以把两数之差取绝对值,再与一个很小的容差值比较。
>>> def approx_eq(x, y, tolerance=1e-15):
        return abs(x - y) < tolerance
以 golden_update 与 square_close_to_successor 为实参调用 improve,便会算出黄金比例的一个有限近似:
>>> improve(golden_update, square_close_to_successor)
1.6180339887498951
沿着求值的各个步骤追溯一遍,就能看清这个结果是如何算出来的。首先,为 improve 构造一个局部帧,其中绑定 update、close 与 guess。在 improve 的函数体里,名字 close 绑定到 square_close_to_successor,它被施加于 guess 的初始值。请继续追随后续步骤,观察计算过程如何演进,最终算出黄金比例。
def improve(update, close, guess=1):
    while not close(guess):
        guess = update(guess)
    return guess

def golden_update(guess):
    return 1/guess + 1

def square_close_to_successor(guess):
    return approx_eq(guess * guess, guess + 1)

def approx_eq(x, y, tolerance=1e-3):
    return abs(x - y) < tolerance

phi = improve(golden_update, square_close_to_successor)
这个例子体现了计算机科学中两个互为表里的大观念。其一,命名与函数让我们得以把大量复杂性抽象掉:每个函数定义都平淡无奇,可我们的求值流程所启动的计算过程却相当错综复杂。其二,正是因为 Python 语言有着一套极其通用的求值流程,微小的组件才得以组合成复杂的过程。理解「解释程序的流程」,使我们能够验证并审视自己创造出来的过程。
一如既往,我们这项新的一般方法 improve 也需要一个测试来检验其正确性。黄金比例恰好能提供这样一个测试——它还有一个精确的闭式解,可以拿来与这个迭代结果作比较。
>>> from math import sqrt
>>> phi = 1/2 + sqrt(5)/2
>>> def improve_test():
        approx_phi = improve(golden_update, square_close_to_successor)
        assert approx_eq(phi, approx_phi), 'phi differs from its approximation'
>>> improve_test()
对这个测试而言,没有消息就是好消息:improve_test 在 assert 语句顺利执行之后返回 None。
定义函数之三:嵌套定义
上面的例子证明:把函数作为实参传递的能力,显著增强了我们编程语言的表达力。每个一般概念或方程,都对应着一段自己的短小函数。这种做法有一个负面后果:全局帧里塞满了小函数的名字,而这些名字必须个个独一无二。另一个问题是,我们受制于特定的函数签名:improve 的 update 参数必须恰好接受一个实参。**嵌套函数定义(Nested function definitions)**同时解决了这两个问题,但需要我们把环境模型加以充实。
让我们考虑一个新问题:计算一个数的平方根。在编程语言中,「平方根」常缩写为 sqrt。反复施加下面这个更新,就会收敛到 a 的平方根:
>>> def average(x, y):
        return (x + y)/2
>>> def sqrt_update(x, a):
        return average(x, a/x)
这个双参数的更新函数与 improve 格格不入(它要两个实参,不是一个);而且它只给出一次更新,而我们真正在乎的恰恰是通过反复更新来求平方根。两个问题的共同解法,是把函数定义放进其他定义的函数体内。
>>> def sqrt(a):
        def sqrt_update(x):
            return average(x, a/x)
        def sqrt_close(x):
            return approx_eq(x * x, a)
        return improve(sqrt_update, sqrt_close)
与局部赋值一样,局部 def 语句只影响当前的局部帧。这些函数仅在 sqrt 被求值期间处于作用域内。这完全符合我们的求值流程:这些局部 def 语句甚至要到 sqrt 被调用时才被求值。
词法作用域
局部定义的函数,同样可以访问其定义所在作用域中的名字绑定。在这个例子里,sqrt_update 引用了名字 a,而 a 是其外围函数 sqrt 的形式参数。这种在嵌套定义之间共享名字的规程,称为词法作用域(lexical scoping)。关键在于:内层函数访问的是定义它们时所在环境的那些名字(而不是调用它们时所在的环境)。
要让词法作用域生效,我们需要对环境模型作两项扩展:
- 每个用户自定义函数都有一个父环境(parent environment):即定义它时所处的环境;
- 当用户自定义函数被调用时,其局部帧的父环境,就是那个父环境。
在 sqrt 之前,所有函数都定义在全局环境中,因此它们的父环境都相同:global。相比之下,当 Python 求值 sqrt 的头两个子句时,它创建的函数便与一个局部环境相关联。在调用
>>> sqrt(256)
16.0
中,环境首先为 sqrt 添加一个局部帧,并求值 sqrt_update 与 sqrt_close 的 def 语句。
def average(x, y):
    return (x + y)/2

def improve(update, close, guess=1):
    while not close(guess):
        guess = update(guess)
    return guess

def approx_eq(x, y, tolerance=1e-3):
    return abs(x - y) < tolerance

def sqrt(a):
    def sqrt_update(x):
        return average(x, a/x)
    def sqrt_close(x):
        return approx_eq(x * x, a)
    return improve(sqrt_update, sqrt_close)

result = sqrt(256)
今后,环境图中的函数值都会多出一项新标注:父环境(parent)。函数值的父环境,就是定义该函数时所处环境的第一个帧。没有父环境标注的函数,都是在全局环境中定义的。当用户自定义函数被调用时,所创建的帧与那个函数有着相同的父环境。
接着,名字 sqrt_update 解析到这个新定义的函数,它被作为实参传给 improve。在 improve 的函数体内,我们必须把这个更新函数(此时绑定于 sqrt_update)施加于初始猜测值 1。这最后一次施加为 sqrt_update 创建了一个环境:它以只含 x 的局部帧为起点,而父帧 sqrt 中仍然含有 a 的绑定。
在这个求值过程中,最关键的一环,是 sqrt_update 的父环境被传递给了「调用 sqrt_update 所创建的帧」。这个帧同样标注着 [parent=f1]。
延展的环境(Extended environments)。 一个环境可以由任意长的帧链构成,链的尽头总是全局帧。在 sqrt 这个例子之前,环境至多只有两个帧:一个局部帧和一个全局帧。通过调用那些定义在其他函数内部的函数(借助嵌套 def 语句),我们可以造出更长的链。这次调用 sqrt_update 的环境由三个帧构成:sqrt_update 的局部帧;定义 sqrt_update 的那个 sqrt 帧(记作 f1);以及全局帧。
sqrt_update 函数体中的返回表达式,可以顺着这条帧链为 a 解析出值来。名字查找,是在当前环境中找出第一个绑定着该名字的值。Python 先查 sqrt_update 帧——没有 a。接着查父帧 f1,发现 a 绑定为 256。
由此,我们领会到 Python 词法作用域的两个关键优势:
- 局部函数的名字不会干扰其定义所在函数之外的任何名字,因为这个局部函数名会绑定在其定义时所在的当前局部环境中,而非全局环境;
- 局部函数可以访问外围函数的环境,因为局部函数的函数体,是在「扩展了其定义环境」的环境中求值的。
sqrt_update 函数随身携带着一些数据:它定义环境中被引用的 a 的值。因为局部函数以这种方式把信息「围拢」(enclose)起来,它们常被称为闭包(closures)。
函数作为返回值
🎬 视频:Functions as Return Values
创建以函数为返回值的函数,能让我们的程序获得更强的表达力。词法作用域编程语言的一个重要特性是:局部定义的函数在被返回时,仍保留其父环境。下面这个例子说明了这一特性的用处。
一旦定义了许多简单函数,**函数复合(function composition)**便成了值得纳入编程语言的一种自然的组合手段。也就是说,给定两个函数 f(x) 与 g(x),我们也许想定义 h(x) = f(g(x))。用现有的工具,就能定义函数复合:
>>> def compose1(f, g):
        def h(x):
            return f(g(x))
        return h
这个例子的环境图表明:即便存在名字冲突,f 与 g 也能被正确解析。
def square(x):
    return x * x

def successor(x):
    return x + 1

def compose1(f, g):
    def h(x):
        return f(g(x))
    return h

def f(x):
    """Never called."""
    return -x

square_successor = compose1(square, successor)
result = square_successor(12)
compose1 中的那个 1,意在表示所复合的函数都接受单个实参。这一命名约定并不由解释器强制实施;那个 1 只不过是函数名的一部分。
至此,我们开始看到「精确定义计算的环境模型」这番工夫的回报:要解释我们何以能够以这种方式返回函数,环境模型无需任何修改。
示例:牛顿法
🎬 视频:Newton's Method
这个篇幅较长的例子展示:函数的返回值与局部定义可以携手并进,简洁地表达一般观念。我们将实现一种广泛用于机器学习、科学计算、硬件设计与优化之中的算法。
牛顿法(Newton's method)是一种经典的迭代方法,用来寻找使某个数学函数返回值为 0 的实参。这样的值称为函数的零点(zeros)。求函数的零点,常常等价于求解某个我们真正关心的问题,比如计算平方根。
动手之前,先说一句有启发性的话:我们太容易把「会算平方根」这件事视为理所当然。不只是 Python,你的手机、浏览器、口袋里的计算器都能替你算。然而,学习计算机科学的一部分,恰恰是理解这类量究竟是如何算出来的;而这里所展示的一般方法,适用于求解 Python 内置能力之外的一大类方程。
牛顿法是一种迭代改进算法:对任何**可微(differentiable)**的函数,它都能改进对零点的猜测。「可微」意味着该函数在任意一点都能用一条直线近似。牛顿法顺着这些线性近似,去逼近函数的零点。
想象一条穿过点 (x, f(x)) 的直线,其斜率与函数 f(x) 曲线在该点的斜率相同。这样的直线称为切线(tangent),其斜率称为 f 在 x 处的导数(derivative)。
这条直线的斜率,是函数值的变化量与函数自变量的变化量之比。因此,把 x 平移 f(x) 除以斜率那么多,得到的便是这条切线与 0 相触处的自变量值。
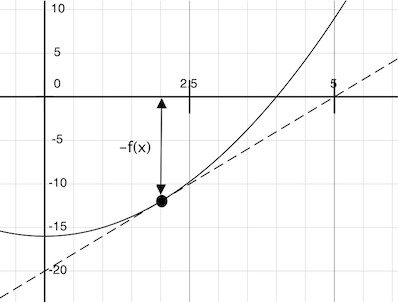
newton_update 表达的正是「顺着这条切线走向 0」的计算过程——给定函数 f 及其导数 df:
>>> def newton_update(f, df):
        def update(x):
            return x - f(x) / df(x)
        return update
最后,我们可以用 newton_update、improve 算法,再加上一个「看看 f(x) 是否已接近 0」的比较,来定义 find_zero 函数:
>>> def find_zero(f, df):
        def near_zero(x):
            return approx_eq(f(x), 0)
        return improve(newton_update(f, df), near_zero)
求根
借助牛顿法,我们可以计算任意 n 次方根。a 的 n 次方根,是满足 x·x·x…x = a(x 重复 n 次)的那个 x。例如:
- 64 的平方(二次)根是 8,因为 8×8 = 64;
- 64 的立方(三次)根是 4,因为 4×4×4 = 64;
- 64 的六次方根是 2,因为 2×2×2×2×2×2 = 64。
基于如下观察,我们便能以牛顿法求根:
- 64 的平方根(记作 √64)是满足 x² − 64 = 0 的那个值 x;
- 更一般地,a 的 n 次方根(记作 ⁿ√a)是满足 xⁿ − a = 0 的那个值 x。
只要能求出后一个方程的零点,也就求得了 n 次方根。画出 n 分别取 2、3、6 而 a 取 64 时的曲线,这种关系便一目了然。
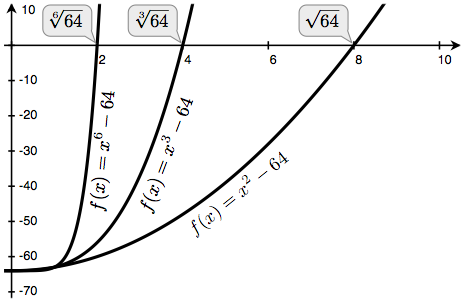
🎬 视频:Iterative Improvement 🎬 视频:Implementing Newton's Method
我们先来实现 square_root_newton,定义 f 及其导数 df。这里用上微积分中的一个事实:f(x) = x² − a 的导数是线性函数 df(x) = 2x。
>>> def square_root_newton(a):
        def f(x):
            return x * x - a
        def df(x):
            return 2 * x
        return find_zero(f, df)
>>> square_root_newton(64)
8.0
推广到任意 n 次方根,我们计算 f(x) = xⁿ − a 及其导数 df(x) = n·xⁿ⁻¹。
>>> def power(x, n):
        """Return x * x * x * ... * x for x repeated n times."""
        product, k = 1, 0
        while k < n:
            product, k = product * x, k + 1
        return product
>>> def nth_root_of_a(n, a):
        def f(x):
            return power(x, n) - a
        def df(x):
            return n * power(x, n-1)
        return find_zero(f, df)
>>> nth_root_of_a(2, 64)
8.0
>>> nth_root_of_a(3, 64)
4.0
>>> nth_root_of_a(6, 64)
2.0
这些计算中的近似误差,都可以通过把 approx_eq 的容差改得更小来削减。
在你玩味牛顿法时,请注意它并不总能收敛。improve 的初始猜测必须足够接近零点,而且函数还得满足种种条件。尽管有这些短板,牛顿法仍是一种强大的通用计算方法,可用来求解可微方程。现代计算机中那些极快的对数算法与大整数除法算法,都采用了这项技术的各种变体。
柯里化
🎬 视频:Currying
我们可以用高阶函数,把接受多个实参的函数,转换成一条「每个函数只接受一个实参」的函数链。更具体地说,给定函数 f(x, y),我们可以定义一个函数 g,使得 g(x)(y) 等价于 f(x, y)。这里的 g 是一个高阶函数:它接受单个实参 x,返回另一个接受单个实参 y 的函数。这种变换称为柯里化(currying)。
举个例子,我们可以定义一个柯里化版本的 pow 函数:
>>> def curried_pow(x):
        def h(y):
            return pow(x, y)
        return h
>>> curried_pow(2)(3)
8
有些编程语言(如 Haskell)只允许函数接受单个实参,因而程序员必须把所有多参数的过程都柯里化。而在 Python 这类更一般的语言中,当我们需要一个只接受单个实参的函数时,柯里化便派上了用场。例如,map 模式会把一个单参数函数施加于一串值。后面的章节我们会看到更一般的 map 模式示例;眼下,我们可以在一个函数里实现这个模式:
>>> def map_to_range(start, end, f):
        while start < end:
            print(f(start))
            start = start + 1
用 map_to_range 与 curried_pow,可以算出 2 的前十次幂,而不必专为这件事写一个函数:
>>> map_to_range(0, 10, curried_pow(2))
1
2
4
8
16
32
64
128
256
512
同样地,用这两个函数可以算出其他数的幂。柯里化让我们不必为每一个想求幂的数专门写函数。
在上面的例子里,我们是手工对 pow 施展柯里化变换,得到 curried_pow 的。其实,我们可以定义函数来自动完成柯里化,以及它的逆变换——去柯里化(uncurrying):
>>> def curry2(f):
        """Return a curried version of the given two-argument function."""
        def g(x):
            def h(y):
                return f(x, y)
            return h
        return g
>>> def uncurry2(g):
        """Return a two-argument version of the given curried function."""
        def f(x, y):
            return g(x)(y)
        return f
>>> pow_curried = curry2(pow)
>>> pow_curried(2)(5)
32
>>> map_to_range(0, 10, pow_curried(2))
1
2
4
8
16
32
64
128
256
512
curry2 接受一个双参数函数 f,返回一个单参数函数 g。当 g 被施加于实参 x 时,它返回一个单参数函数 h。当 h 被施加于 y 时,它调用 f(x, y)。于是,curry2(f)(x)(y) 等价于 f(x, y)。uncurry2 函数则逆转柯里化变换,使得 uncurry2(curry2(f)) 等价于 f。
>>> uncurry2(pow_curried)(2, 5)
32
Lambda 表达式
🎬 视频:Lambda Expressions
到目前为止,每当想定义一个新函数,我们都得给它起个名字。但对其他类型的表达式,我们并不需要把中间值跟名字关联起来。也就是说,我们可以在不给子表达式 ab、cd 或整个表达式命名的前提下,算出 ab + cd。在 Python 中,我们可以用 lambda 表达式随手创建函数值——其求值结果是一个未命名的函数。lambda 表达式求值所得的函数,以单个返回表达式为函数体;赋值语句与控制语句都不允许出现。
>>> def compose1(f, g):
        return lambda x: f(g(x))
构造一个对应的英文句子,就能理解 lambda 表达式的结构:
lambda        x        :        f(g(x))
“一个函数,  接受 x,  并返回   f(g(x))”
lambda 表达式的结果称为 lambda 函数。它没有内在名字(因此 Python 打印名字时显示 <lambda>),除此之外,举止与任何其他函数无异。
>>> s = lambda x: x * x
>>> s
<function <lambda> at 0xf3f490>
>>> s(12)
144
在环境图中,lambda 表达式的结果同样是一个函数,名字用希腊字母 λ 表示。我们的 compose 例子,可以用 lambda 表达式写得相当紧凑。
def compose1(f, g):
    return lambda x: f(g(x))

f = compose1(lambda x: x * x,
             lambda y: y + 1)
result = f(12)
有些程序员觉得,使用 lambda 表达式得来的无名函数,写起来更短、更直接。然而,复合的 lambda 表达式虽然简短,却出了名地难读。下面这个定义是正确的,但许多程序员都难以一眼看懂:
>>> compose1 = lambda f,g: lambda x: f(g(x))
总的来说,Python 的风格偏好显式的 def 语句,而非 lambda 表达式;但当需要一个简单函数作为实参或返回值时,lambda 是被允许的。
这类风格规则仅仅是准则;你想怎么写,就可以怎么写。不过,在写程序时,请想想将来某一天可能读到你程序的那些读者。每当你能让程序更好懂一点,便是在帮他们一把。
「lambda」这个词,是一个历史的偶然产物,源于书写的数学记号与早期排版系统的限制之间的不合。
用 lambda 来引入一个过程/函数,乍看颇有几分乖谬。这个记号可追溯到 Alonzo Church:20 世纪 30 年代,他起初用一个「帽子」符号,把平方函数写作「ŷ . y × y」。但被折腾得够呛的排字工把帽子挪到了参数左边,又改成了大写 lambda:「Λy . y × y」;再往后,大写 lambda 又变成了小写,于是如今的数学书里写着「λy . y × y」,而 Lisp 里则写作
(lambda (y) (* y y))。—— Peter Norvig(norvig.com/lispy2.html)
尽管词源颇为奇特,lambda 表达式及其对应的形式语言——用于函数应用的 lambda 演算(lambda calculus)——都是计算机科学的基本概念,其影响远远超出 Python 编程共同体。待第 3 章研究解释器的设计时,我们会重温这个话题。
抽象与一等函数
🎬 视频:Abstraction
本节开头我们指出:用户自定义函数是一种关键的抽象机制,因为它们让我们能把一般的计算方法写成编程语言中的显式元素。现在我们已经看到,高阶函数如何让我们操作这些一般方法,从而创造出进一步的抽象。
作为程序员,我们应当敏锐地留意那些可以识别出程序中底层抽象的机会,在此基础上构建、推广,从而创造出更强大的抽象。这并不是说,写程序就该永远以尽可能最抽象的方式去写;老练的程序员懂得如何选择与任务相称的抽象层次。但重要的是,要能以这些抽象来思考,从而随时准备把它们应用于新的语境。高阶函数的意义在于:它们使我们能够把这些抽象显式地表示为编程语言中的元素,从而像对待其他计算元素一样对待它们。
总的来说,编程语言会对「计算元素可被操作的方式」施加限制。所受限制最少的元素,据说具有一等地位(first-class status)。一等元素的一些「权利与特权」是:
- 可以绑定到名字;
- 可以作为实参传递给函数;
- 可以作为函数的返回值;
- 可以放进数据结构。
Python 赋予函数完全的一等地位,由此带来的表达力提升是巨大的。
函数装饰器
🎬 视频:Decorators
Python 提供了特殊的语法,用来在 def 语句执行过程中施加高阶函数,这种语法称为装饰器(decorator)。最常见的例子或许是 trace(跟踪):
>>> def trace(fn):
        def wrapped(x):
            print('-> ', fn, '(', x, ')')
            return fn(x)
        return wrapped
>>> @trace
    def triple(x):
        return 3 * x
>>> triple(12)
->  <function triple at 0x102a39848> ( 12 )
36
这个例子里定义了一个高阶函数 trace,它返回的函数会在调用其参数之前,先执行一条打印语句,输出那个实参。triple 的 def 语句带着一个标注 @trace,它影响了 def 的执行规则。照常,函数 triple 被创建出来。然而,名字 triple 并不绑定到这个函数上;相反,它绑定到「对新定义的 triple 函数调用 trace」所返回的那个函数值上。在代码中,这个装饰器等价于:
>>> def triple(x):
        return 3 * x
>>> triple = trace(triple)
在与本书配套的项目中,装饰器被用于跟踪,也用于在从命令行运行程序时挑选要调用哪些函数。
给专家的额外内容。 装饰器符号 @ 之后也可以跟一个调用表达式。@ 后面的表达式先求值(就像上面的名字 trace 那样),def 语句其次,最后,把装饰器表达式的求值结果施加于新定义的函数,所得结果绑定到 def 语句中的那个名字上。
译者注:1.6 原文中的交互式环境图,同样改写为程序片段与文字说明。
1.7 递归函数
🎬 视频:Recursive Functions
若一个函数的函数体调用了该函数自身——无论是直接还是间接,这个函数就称为递归函数(recursive function)。也就是说,执行递归函数的函数体的过程,可能反过来又需要施加这个函数。递归函数在 Python 中并不使用什么特殊语法,但要理解和编写它们,确实得费些功夫。
我们从一个示例问题入手:写一个函数,求一个自然数的各位数字之和。设计递归函数时,我们要寻找把问题拆解成更简单问题的途径。在本例中,运算符 % 与 // 可以把一个数拆成两部分:最后一位,以及除最后一位以外的所有位。
>>> 18117 % 10
7
>>> 18117 // 10
1811
18117 的各位数字之和是 1+8+1+1+7 = 18。正如我们可以拆分这个数,我们也可以把这个和拆成最后一位数字 7,以及除最后一位之外各位之和 1+8+1+1 = 11。这一拆分给出一个算法:要求 n 的各位数字之和,就把它的最后一位 n % 10,加到 n // 10 的各位数字之和上。有一个特殊情形:若一个数只有一位,那么它的各位数字之和就是它自己。这个算法可以写成一个递归函数:
>>> def sum_digits(n):
        """Return the sum of the digits of positive integer n."""
        if n < 10:
            return n
        else:
            all_but_last, last = n // 10, n % 10
            return sum_digits(all_but_last) + last
sum_digits 的这个定义既完整又正确,尽管 sum_digits 函数在自己的函数体中被调用了。求各位数字之和的问题被拆成两步:先求除最后一位之外的各位之和,再加上最后一位。这两步都比原问题更简单。之所以说这个函数是递归的,是因为第一步与原来的问题是同一类问题。也就是说,sum_digits 正是我们实现 sum_digits 所需要的那个函数。
>>> sum_digits(9)
9
>>> sum_digits(18117)
18
>>> sum_digits(9437184)
36
>>> sum_digits(11408855402054064613470328848384)
126
借助我们的环境计算模型,我们可以精确地理解这个递归函数为何能成功施用。无需任何新规则。
def sum_digits(n):
    if n < 10:
        return n
    else:
        all_but_last, last = n // 10, n % 10
        return sum_digits(all_but_last) + last

sum_digits(738)
执行 def 语句时,名字 sum_digits 绑定到一个新函数上,但该函数的函数体尚未执行。因此,sum_digits 的循环性质此时还不成问题。接着,sum_digits 被施加于 738:
- 为
sum_digits创建一个局部帧,n绑定为 738,sum_digits的函数体就在以这个帧为起点的环境中执行; - 因为 738 不小于 10,执行第 5 行的赋值语句,把 738 拆成 73 与 8;
- 在接下来的 return 语句中,
sum_digits被施加于 73,即当前环境中all_but_last的值; - 又为
sum_digits创建一个局部帧,这次n绑定为 73;sum_digits的函数体再次在以此帧为起点的新环境中执行; - 因为 73 也不小于 10,73 被拆成 7 与 3,
sum_digits被施加于 7,即在该帧中求得的all_but_last的值; - 为
sum_digits创建第三个局部帧,n绑定为 7; - 在以此帧为起点的环境中,
n < 10为真,于是返回 7; - 在第二个局部帧中,返回值 7 与
last的值 3 相加,返回 10; - 在第一个局部帧中,返回值 10 与
last的值 8 相加,返回 18。
这个递归函数尽管有循环的性质,却能正确施用,因为它虽然被施用了两次,但每次的实参都不相同;而且第二次施用是「各位数字求和」问题的一个更简单的实例。请为调用 sum_digits(18117) 画出环境图,你会看到每一次相继的 sum_digits 调用所取的实参都比上一次更小,直到最终到达一个只有一位的输入。
这个例子也表明:函数体简单的函数,借助递归也能演化出复杂的计算过程。
递归函数的解剖
🎬 视频:Recursion in Environment Diagrams
在许多递归函数的函数体中,都能找到一个共同的模式。函数体以**基准情形(base case)**开头——那是一条条件语句,规定了函数在处理最简单的输入时的行为。就 sum_digits 而言,基准情形是任何只有一位的实参,我们直接返回该实参。有些递归函数会有多个基准情形。
基准情形之后,则是一个或多个递归调用(recursive calls)。递归调用总有一种特定的性格:它们简化了原问题。递归函数通过逐步简化问题来表达计算。例如,求 7 的各位数字之和,比求 73 的各位数字之和更简单;而后者又比求 738 的各位数字之和更简单。每一次后续调用,待办的工作都更少。
递归函数解决问题的方式,往往与我们此前用过的迭代方法不同。考虑一个计算 n 的阶乘的函数 fact,例如 fact(4) 计算 4! = 4·3·2·1 = 24。
用 while 语句的一种自然实现,是把 1 到 n 的每个正整数依次乘进来,累积出总数。
>>> def fact_iter(n):
        total, k = 1, 1
        while k <= n:
            total, k = total * k, k + 1
        return total
>>> fact_iter(4)
24
另一方面,阶乘的递归实现,可以用 fact(n-1)——一个更简单的问题——来表达 fact(n)。递归的基准情形是问题的最简形式:fact(1) 就是 1。
def fact(n):
    if n == 1:
        return 1
    else:
        return n * fact(n-1)

fact(4)
这两个阶乘函数在观念上有所不同。迭代函数从基准情形 1 出发,通过逐项相乘构造出最终结果;而递归函数则直接从最后一项 n,以及更简单问题的结果 fact(n-1) 出发,构造出结果。
随着递归通过一次次施加 fact 于越来越简单的问题实例而「展开」(unwind),结果最终自基准情形起被构造出来。递归在把实参 1 传给 fact 时结束;每次调用的结果都依赖下一次调用,直至抵达基准情形。
这个递归函数的正确性,从阶乘的数学定义即可轻易验证:
(n-1)! = (n-1)·(n-2)·…·1
n!     = n·(n-1)·(n-2)·…·1
n!     = n·(n-1)!
我们固然可以用计算模型把递归「摊开」来看,但把递归调用视为函数抽象,往往更为清晰。也就是说,我们不该操心 fact(n-1) 在 fact 的函数体中是如何实现的;我们只管相信它算出了 n-1 的阶乘。把递归调用当作函数抽象,这种做法被称为递归的信仰之跃(recursive leap of faith)。我们用一个函数自身来定义它,但在验证其正确性时,只管相信更简单的情形会正确工作。在这个例子里,我们相信 fact(n-1) 会正确算出 (n-1)!;我们只需检查:在此假设之下,n! 是否被正确算出。如此一来,验证递归函数的正确性,便成了数学归纳法的一种形式。
fact_iter 与 fact 还有一处不同:前者必须引入两个额外的名字 total 与 k,而递归实现并不需要。总的来说,迭代函数必须维护某种局部状态,这种状态在计算过程中不断变化。在迭代的任何一个时刻,这种状态刻画着「已完成工作」的结果与「剩余工作量」。例如,当 k 为 3、total 为 2 时,还有两项待处理,即 3 与 4。相比之下,fact 只由它唯一的实参 n 来刻画。计算的状态完全蕴含在环境的结构之中:环境的返回值扮演着 total 的角色,并在不同的帧中把 n 绑定到不同的值,而非显式地追踪 k。
递归函数利用了「求值调用表达式以把名字绑定到值」的规则,往往省去了迭代过程中正确指派局部名字的麻烦。正因如此,递归函数可能更容易被正确地定义出来。然而,要学会辨识递归函数所演化出的计算过程,那必然需要一番练习。
相互递归
🎬 视频:Mutual Recursion
当一个递归过程被分置于两个互相调用的函数之中时,这两个函数就称为**相互递归(mutually recursive)**的。举个例子,考察下面关于非负整数「偶」与「奇」的定义:
- 一个数是偶数,当且仅当它比某个奇数多 1;
- 一个数是奇数,当且仅当它比某个偶数多 1;
- 0 是偶数。
依据这一定义,我们可以实现两个相互递归的函数,来判断一个数是偶数还是奇数:
def is_even(n):
    if n == 0:
        return True
    else:
        return is_odd(n-1)

def is_odd(n):
    if n == 0:
        return False
    else:
        return is_even(n-1)

result = is_even(4)
打破两个函数之间的抽象边界,相互递归的函数便可化归为单个递归函数。在这个例子里,可以把 is_odd 的函数体并入 is_even 的函数体——只需把 is_odd 函数体中的 n 换成 n-1,以反映传给它的实参:
>>> def is_even(n):
        if n == 0:
            return True
        else:
            if (n-1) == 0:
                return False
            else:
                return is_even((n-1)-1)
由此可见,相互递归并不比简单的递归更神秘、更强大;不过,它为在复杂的递归程序中维持抽象提供了一种机制。
递归函数中的打印
🎬 视频:Order of Recursive Calls
递归函数所演化出的计算过程,常常可以通过调用 print 来可视化。举个例子,我们来实现一个函数 cascade:它把一个数的所有前缀,按从大到小再到大(先降后升)的顺序打印出来。
>>> def cascade(n):
        """Print a cascade of prefixes of n."""
        if n < 10:
            print(n)
        else:
            print(n)
            cascade(n//10)
            print(n)
>>> cascade(2013)
2013
201
20
2
20
201
2013
在这个递归函数中,基准情形是个一位数,直接打印。否则,递归调用就夹在两处 print 调用之间。
🎬 视频:Example: Inverse Cascade
把基准情形写在递归调用之前,并非硬性要求。事实上,观察到 print(n) 在条件语句的两个子句中重复出现,因而可以提到条件语句之前,这个函数就能表达得更紧凑:
>>> def cascade(n):
        """Print a cascade of prefixes of n."""
        print(n)
        if n >= 10:
            cascade(n//10)
            print(n)
再看一个相互递归的例子。考虑一个双人游戏:桌上初始有 n 颗石子。双方轮流从桌上取走一颗或两颗石子,取走最后一颗石子者获胜。假设 Alice 与 Bob 玩这个游戏,各自采用一套简单的策略:
- Alice 总是取走一颗石子;
- Bob 若见桌上石子数为偶数便取走两颗,否则取走一颗。
给定初始石子数 n,且 Alice 先手,谁获胜?
这个问题的一种自然分解,是把每套策略封装进各自的函数。这样一来,改动其中一套策略便不会影响另一套,两人之间的抽象屏障得以维持。为了体现游戏一回合接一回合的性质,这两个函数在每回合结束时互相调用:
>>> def play_alice(n):
        if n == 0:
            print("Bob wins!")
        else:
            play_bob(n-1)
>>> def play_bob(n):
        if n == 0:
            print("Alice wins!")
        elif is_even(n):
            play_alice(n-2)
        else:
            play_alice(n-1)
>>> play_alice(20)
Bob wins!
在 play_bob 中我们看到,一个函数的函数体里可以出现多处递归调用。不过在这个例子里,每次调用 play_bob 最多只调用一次 play_alice。下一节我们要考察的,是当一次函数调用直接发起多处递归调用时,会发生什么。
树递归
🎬 视频:Tree Recursion
另一种常见的计算模式称为树递归(tree recursion):函数不止一次地调用自身。举个例子,考察斐波那契数列的计算,其中每个数都是前两个数之和。
def fib(n):
    if n == 0:
        return 0
    if n == 1:
        return 1
    else:
        return fib(n-2) + fib(n-1)

result = fib(6)
与我们此前的种种尝试相比,这个递归定义格外动人:它与我们熟悉的斐波那契数定义分毫不差。带有多个递归调用的函数,据说就是树递归的——因为每一次调用都会分岔出多个更小的调用,每一个又分岔出更小的调用,正如树木的枝条自树干延伸出去,越分越细,也越来越多。
我们早先就已经能够不用树递归来定义计算斐波那契数的函数了。事实上,我们此前的尝试效率更高——这个话题将在 2.9 节讨论。接下来,我们考察一个问题:树递归的解法要比任何迭代方案都简单得多。
示例:整数划分
🎬 视频:Tree Recursion (Part 2)
正整数 n 使用不超过 m 的部分的划分数(number of partitions),是指把 n 表示成若干个不大于 m 的正整数之和(按递增顺序排列)的方法数。例如,用不超过 4 的部分来划分 6,共有 9 种方法:
- 6 = 2 + 4
- 6 = 1 + 1 + 4
- 6 = 3 + 3
- 6 = 1 + 2 + 3
- 6 = 1 + 1 + 1 + 3
- 6 = 2 + 2 + 2
- 6 = 1 + 1 + 2 + 2
- 6 = 1 + 1 + 1 + 1 + 2
- 6 = 1 + 1 + 1 + 1 + 1 + 1
我们来定义一个函数 count_partitions(n, m),返回用不超过 m 的部分划分 n 的不同方法数。这个函数有一个简单的树递归解法,依据如下观察:
用不超过 m 的整数划分 n 的方法数,等于
- 用不超过 m 的整数划分 n−m 的方法数,加上
- 用不超过 m−1 的整数划分 n 的方法数。
要弄清这条为何成立,请注意:所有划分 n 的方法可以分为两组——包含了至少一个 m 的,以及不包含 m 的。而且,第一组中的每一种划分,都是先划分 n−m,再在末尾加一个 m。在上面的例子里,前两种划分含有 4,其余的不含。
因此,我们可以把「用不超过 m 的整数划分 n」这一难题,递归地化归为两个更简单的问题:(1) 划分一个更小的数 n−m;(2) 用更小的部分(不超过 m−1)来划分。
为了完成实现,还需规定如下基准情形:
- 划分 0 有 1 种方法:不取任何部分;
- 划分负数有 0 种方法;
- 用大小为 0 或更小的部分来划分任何大于 0 的 n,有 0 种方法。
>>> def count_partitions(n, m):
        """Count the ways to partition n using parts up to m."""
        if n == 0:
            return 1
        elif n < 0:
            return 0
        elif m == 0:
            return 0
        else:
            return count_partitions(n-m, m) + count_partitions(n, m-1)
>>> count_partitions(6, 4)
9
>>> count_partitions(5, 5)
7
>>> count_partitions(10, 10)
42
>>> count_partitions(15, 15)
176
>>> count_partitions(20, 20)
627
我们可以把树递归函数看作在探索各种可能性。在本例中,我们探索「用一个大小为 m 的部分」与「不用」这两种可能。第一次与第二次递归调用,正对应着这两种可能。
不用递归来实现这个函数,会麻烦得多。有兴趣的读者不妨一试。
函数参考
第 1 章讨论了表达式、名字、赋值、控制与函数。本节收录本章最重要的定义,以及一份内置函数清单,还有一些示例中出现的数学背景材料。
表达式
**表达式(expression)**是可以被求值、因而具有值的代码。
学习 Python,就包括学习它各种形式的表达式以及求值方式。重要的表达式类型包括:
- 数字:求值为自身——
3.14求值为数字 3.14; - 名字:求值为其在当前环境中的值;
- 调用表达式:把某个函数作用于若干实参。
名字
程序可以有各种行为(例如显示消息、发送电子邮件等等),但它们大多是为操作值而存在的。**值(value)**是对某份数据的统称,它可以是单个数字,也可以是整份文档。本课程开始时只关注少数几种值:数字、布尔值(True 与 False)、None 值、字符串以及函数。
代码中包含名字(names),它们指称值。一切表达式都在某种环境中求值——环境是 Python 解释器中追踪「哪个名字指称哪个值」的那一部分。当一个名字与一个值在环境中绑定在一起时,该名字在该环境中就求值为那个值。
说「名字绑定到一个值」,与说「一个值被赋给了一个名字」,意思相同。
调用表达式
下面是两个调用表达式及其值的例子:
pow(2, 10)
pow(1 + 1, min(3, abs(-4)))
调用表达式在圆括号之前有一个表达式,本课程称之为运算符表达式。[1] 运算符几乎总是名字,它求值为被调用的函数。
调用表达式的圆括号内还有一些以逗号分隔的表达式,本课程称之为操作数表达式,它们求值为函数的实参。
Python 求值调用表达式的过程是:先求值运算符,再求值各操作数,然后把函数(即运算符的值)施加于其各实参(即各操作数的值)。把函数施加于若干实参,会返回一个值;调用表达式的值,就是被调用函数所返回的那个值。
例如,在 pow(1 + 1, min(3, abs(-4))) 中:
- 运算符是名字
pow,其值是内置的pow函数; - 操作数是
1 + 1与min(3, abs(-4)),它们的值分别是 2 与 3; - 把
pow函数施加于 2 与 3,返回 8——这就是整个表达式的值。
内置函数
Python 运行所有程序时都从全局环境起步。起初,许多名字都绑定着内置函数。例如,名字 max 起初绑定着内置的 max 函数。本课程第一单元用到的内置函数有:
pow总是接受两个数字。pow(x, y)返回 x 的 y 次幂。pow(2, 3)返回 8。abs接受单个数字,返回其绝对值。abs(-5)返回 5。bool接受单个实参,若该实参为真值(有时称作 truthy 值)则返回True,否则返回False。一些假值:0、False、''、None。其他所有数字与字符串都是真值,所有函数亦然。str为任意值返回一个字符串。str(123)返回'123'。round接受一个数字,并可选地接受要保留的小数位数,返回四舍五入后的数。round(3.14159, 2)返回 3.14,round(3.5)返回 4。max接受两个或更多实参,返回其中最大的一个。max(1, 5, 3)返回 5。min接受两个或更多实参,返回其中最小的一个。min(1, 5, 3)返回 1。len接受一个有长度的实参(如字符串),返回该字符串的长度。它不能施加于数字。
第 2 章我们还会学到调用 max 与 min 的其他方式,也会学到许多别的内置函数,比如 sum。一个常见的陷阱:在 Python 中,sum(2, 3) 并不返回 5。请改用 add(2, 3) 或 2 + 3。
有些函数需要导入。第一单元用到的有:
add总是接受两个实参,二者可以都是数字,或都是字符串。add(2, 3)返回 5,add('two', 'three')返回twothree。对任意两个表达式 x 与 y,add(x, y)的值与行为都与x + y相同。sub(x, y)等同于x - y。mul(x, y)等同于x * y。floordiv(x, y)等同于x // y。truediv(x, y)等同于x / y。
数字
本课程的许多例子涉及与数字相关的概念,比如倍数与因数。
作业与试卷上出现的定义,力求简短、一般、精确,而不追求直观与口语化。例如,定义「倍数」一词时,你不会看到:「10 的倍数是 20、30、40、50,等等。它们就是把同一个数反复相加所得的结果。」这个定义有问题:一来「等等」并不精确,二来它留下了许多悬而未决的问题,比如 0、10、−20 是不是 10 的倍数。你看到的会是:「若存在整数 b 使得 n 等于 m * b,则称 n 是整数 m 的倍数。」这个定义更短,并且说明了 0、10、−20 和 20、30、40、50 一样,都是 10 的倍数。
以下是一些与数字有关的有用概念:
若只要 y > x 就有 f(y) > f(x),则称函数 f 是递增的(increasing)。递增函数 f 的一些性质包括:
- 对任意 x 与任意正数 a,f(x + a) > f(x);
- f(max(x, y)) = max(f(x), f(y))。
一个密切相关的概念是非递减(non-decreasing):若只要 y > x 就有 f(y) ≥ f(x),则称函数 f 是非递减的。非递减函数 f 的性质与之相仿:
- 对任意 x 与任意正数 a,f(x + a) ≥ f(x);
- f(max(x, y)) = max(f(x), f(y))。
若 n/k 是整数,则称正整数 k 是正整数 n 的因数(factor)。当 n/k 为整数时,我们说 k **整除(evenly divides)**n。一些性质:
- k 是 n 的因数,当且仅当 n 是 k 的倍数;
- 对任意 n,至少有 1 与 n 两个因数。若只有这两个因数,则 n 是素数(prime)。
用整数 k 除整数 n 所得的余数(remainder),是满足「存在整数 d 使 k*d + r 等于 n」的最小的 r。把 n 除以……
- 10,所得余数是 n 的最后一位;
- 100,所得余数是 n 的最后两位;
- pow(10, p)(p 为正整数),所得余数是 n 的最后 p 位。
注释
- 运算符表达式在不同的文档中有不同的叫法。例如,Python 文档中称之为 primary。↩
第 2 章 数据
2.1 引言
第 1 章我们专注于计算过程,以及函数在程序设计中的角色。我们看到了如何使用基本数据(数字)与基本操作(算术),如何通过复合与控制来构成复合函数,以及如何通过为过程命名来创造函数抽象。我们还看到,高阶函数让我们能以一般的计算方法来操作、进而推理,从而增强了语言的表达力。这已触及编程的许多精髓。
本章聚焦于数据。这里研究的各项技术,将让我们能够表示并操作来自众多不同领域的信息。由于互联网的爆炸式增长,海量结构化信息在网上免费向所有人敞开,计算得以施用于极其广泛的各种问题。有效使用内置数据类型与用户自定义数据类型,是数据处理应用的根本。
原生数据类型
Python 中的每个值都有一个类(class),决定着它是什么类型的值。同属一类的值,行为也相同。例如,整数 1 与 2 都是 int 类的实例,这两个值可以被同样对待——比如都能取负,或与另一个整数相加。内置的 type 函数让我们得以查看任意值的类。
>>> type(2)
<class 'int'>
我们至今用到的值,都是 Python 语言内置的少数几种**原生数据类型(native data types)**的实例。原生数据类型具有如下性质:
- 有若干表达式求值为原生类型的值,这些表达式称为字面量(literals);
- 有内置的函数与运算符来操作原生类型的值。
int 类是用来表示整数的原生数据类型。整数字面量(相邻数字符号组成的序列)求值为 int 值,而数学运算符则操作这些值。
>>> 12 + 3000000000000000000000000
3000000000000000000000012
Python 包含三种原生数值类型:整数(int)、实数(float)与复数(complex)。
>>> type(1.5)
<class 'float'>
>>> type(1+1j)
<class 'complex'>
浮点数
float 这个名字,源自实数在 Python 及许多其他编程语言中的表示方式:浮点(floating point)表示法。数字在计算机内部究竟如何表示,并不是本书的话题;但 int 与 float 对象之间的一些高层差别,却值得了解。尤其是:int 对象精确地表示整数,没有任何近似,大小也不设上限。相形之下,float 对象能表示范围广泛的小数,但并非所有数都能被精确表示,而且有最小值和最大值。因此,float 值应当被当作实数的近似值来对待。这些近似只具有有限的精度。把 float 值组合起来,会带来近似误差;若不是因为近似,下面两个表达式的结果都该是 7:
>>> 7 / 3 * 3
7.0
>>> 1 / 3 * 7 * 3
6.999999999999999
上面虽然组合的都是 int 值,但一个 int 除以另一个 int,得到的却是 float 值:一个对两整数之商所作的截断式有限近似。
>>> type(1/3)
<class 'float'>
>>> 1/3
0.3333333333333333
当我们做相等性检验时,这种近似带来的问题便会浮现:
>>> 1/3 == 0.3333333333333333  # 当心浮点近似
True
int 类与 float 类之间这些微妙的差别,对写程序有着广泛的影响,因此是程序员必须背下来的细节。所幸,原生数据类型屈指可数,要精通一门编程语言,需要记的东西也就有限。而且,同样的细节在许多编程语言之间都是一致的——由 IEEE 754 浮点标准之类的共同体规范所保障。
非数值类型
值可以表示许多其他类型的数据,如声音、图像、位置、网址、网络连接等等。其中一些由原生数据类型表示,比如表示 True 与 False 的 bool 类,以及表示 'Hello, World!' 这类文本值的 str 类。而许多其他值的类型,必须由程序员用本章将要展开的组合手段与抽象手段来定义。
本章将介绍 Python 的许多原生数据类型,以及我们即将创造的新类型。想了解更多的读者,可以参阅在线书籍 Dive Into Python 3 中讲述原生数据类型的章节——它对 Python 全部原生数据类型及其操作做了实用的概览,包含大量用法示例与实践窍门。
与类型打交道
各编程语言对待数据类型的方式不尽相同。Python 围绕类型来组织,却不要求在代码中显式地写出类型。相同类型的值,在许多场合可以被同一个函数互换使用(比如 int 值与 float 值)。不过,有时检查、标注或依据值的类型作条件判断,是有用的。
类型检查
内置函数 isinstance 接受一个值与一个类,若该值是该类的实例便返回真。例如,show 会把 float 值四舍五入后再打印,而其他值照原样打印。
>>> def show(n):
        if isinstance(n, float):
            print(round(n, 2))
        else:
            print(n)
>>> show(100 / 3)
33.33
>>> show(100 > 5)
True
类型强制转换
把一种类型的值转换为另一种类型中相等价的值,这一过程称为类型强制转换(type coercion)。一种原生类型的值,在某些情况下可以转换为另一种。所有值都能转换为 str;仅含数字的字符串可以转换为 int(若没有小数部分)或 float。把一个类型施加于一个值,即执行转换。
>>> str(12)
'12'
>>> float('34.56')
34.56
>>> int(78.0)
78
>>> int('9')
9
类型提示
大多数函数是为施加于特定类型的值而设计的。函数可以为它的形式参数(即其各实参的名字)以及返回值(跟在 -> 符号之后)标注预期类型。这些标注在 Python 中称为类型提示(type hints)。在下面的例子里,形式参数 x 与返回值都标注为 int 值。
>>> def square(x: int) -> int:
        return x * x
>>> square(5)
25
类型提示并不是对函数能接受和返回什么的限制,而是对该函数预期用途的文档。尽管有类型提示,这个 square 函数照样可以接受并返回 float 值,而且能顺利返回。
>>> square(1.4142)
1.9999616399999998
square 函数也可以施加于 str 实参,例如 square('three')——这会引发 TypeError,但原因并不在类型提示。square 的调用本身是被允许的,错误发生在 Python 解释器试图求值 x * x、而 x 绑定着一个 str 值之时。
联合类型(Union types)。 一个既能接受 str 又能接受 float 的函数,可以标注联合类型 str | float。下面这个 double 函数把一个数翻倍,遇到 str 实参时先转成 float、再转回来。
>>> def double(x: str | float) -> str | float:
        if isinstance(x, str):
            return str(2 * float(x))
        else:
            return 2 * x
>>> double('3')
'6.0'
>>> double(3.5)
7.0
类型别名(Type aliases)。 为类型起个名字的办法之一,是使用 type 语句。用户自定义的类型名按惯例首字母大写。新类型名一经引入,便可用于类型提示。
type Quantity = str | float

def double(x: Quantity) -> Quantity:
    if isinstance(x, str):
        return str(2 * float(x))
    else:
        return 2 * x
类型变量(Type variables)。 类型变量用来描述「接受并返回相关类型」的函数。通常用一个名字(往往取作 T)来表示:同样的类型出现在两个或更多形式参数或返回值之中。例如,恒等函数接受任意类型的实参并把它返回。
def identity[T](x: T) -> T:
    return x
此外,类型变量还可以被约束为一组其他类型之一。下面针对 square 函数的这条提示表明:它既能接受 int 值也能接受 float 值,而返回值与其实参同属一种类型。
def square[T: (int, float)](x: T) -> T:
    return x * x
类型变量与类型别名的这套语法,是最近才引入的——2023 年发布的 Python 3.12。若你尝试这些例子时见到 SyntaxError,请升级到较新的 Python 版本。
类型检查器(Type checkers)。 类型提示可以被类型检查——这一过程不执行 Python 文件,而是审查其中的代码,判断标注了类型的名字是否会被绑定到相容的值上;同样,它也检查函数的所有返回值是否与其标注的返回类型相容。安装了 Microsoft Python 扩展的 Visual Studio Code 编辑器,能在你编辑 Python 源文件时检测出类型不相容,但这一类型检查默认关闭。要开启它,请在 Mac 上从 Code 菜单选择 Settings,或在 Windows 上从 File 菜单选择 Preferences,然后把名为 Python › Analysis: Type Checking Mode 的设置从 off 改为 standard;搜索「type checking mode」即可找到该设置。此后,类型不相容之处便会被红线标为错误。Python 的类型检查并不仅限于 VS Code,许多编辑器都可以配置。
类型提示是可选的,有时反而会让程序更难读。即便不加类型提示,类型检查器往往也能推断出形式参数与返回值的类型。在大型 Python 程序中,类型提示正变得越来越普遍,但请记住:为函数标注类型,并不会改变它的行为。
2.2 序列
序列(sequence)是值的有序集合。序列在 Python 中并不是某个特定内置类型的实例,而是一种抽象:一组行为的集合。
长度(Length)。 序列具有有限的长度;空序列的长度为 0。
取项(Item selection)。 对于任何小于其长度的非负整数下标(index),序列都有一个与之对应的项;第一项的下标从 0 开始。
序列虽是项的集合(项本身也是值),但每个序列自身同样是一个值。也就是说,序列可以被赋予名字、作为实参传递,或从函数返回。
这些行为为若干不同的数据类型所共享,其中最重要的便是列表(list)。
列表
把若干表达式放进方括号、以逗号分隔,即可构造一个列表。这样的表达式称为列表字面量(list literal)。
>>> [10, 20]
[10, 20]
访问列表中的项有两种方式。第一种是我们熟悉的多重赋值——它把列表拆解为各项,并将每一项绑定到不同的名字。
>>> pair = [10, 20]
>>> pair
[10, 20]
>>> x, y = pair
>>> x
10
>>> y
20
第二种访问列表各项的方式,是取项运算符(item selection operator),同样用方括号表示。与列表字面量不同,紧跟在另一个表达式之后的方括号表达式,求值的不是列表值,而是从前面那个表达式的值中选出一项。
>>> pair[0]
10
>>> pair[1]
20
Python 中的列表(以及大多数其他编程语言中的序列)采用 0 起下标(0-indexed):下标 0 选出第一项,下标 1 选出第二项,依此类推。支持这一下标约定的一个直觉是:下标表示该项距离列表开头有多远。
与取项运算符等价的函数称为 getitem,它同样用 0 起的下标从列表中选出一项。
>>> from operator import getitem
>>> getitem(pair, 0)
10
>>> getitem(pair, 1)
20
列表可以有任意有限的长度,现代计算机能处理包含数百万项的列表。
内置函数 len 返回序列的长度。下面 digits 是一个含四项的列表,下标 3 处的项是 8。
>>> digits = [1, 8, 2, 8]
>>> len(digits)
4
>>> digits[len(digits) - 1]
8
列表可以相加,也可以乘以整数。对序列来说,加法与乘法并非把各项相加或相乘,而是把序列本身拼接、复写。也就是说,+ 运算符(以及 operator 模块中的 add 函数)返回一个列表,它是各相加列表实参的连接;* 运算符(以及 operator 中的 mul 函数)接受一个列表与一个整数 k,返回由原列表重复 k 次构成的列表。
>>> [2, 7] + digits * 2
[2, 7, 1, 8, 2, 8, 1, 8, 2, 8]
任何值都可以放进列表,包括另一个列表。取项可以反复施加,从而在「列表套列表」的结构中选出深层嵌套的项。
>>> pairs = [[10, 20], [30, 40]]
>>> pairs[1]
[30, 40]
>>> pairs[1][0]
30
允许列表包含其他列表,使我们得以构造层次结构(hierarchical structures)——由部件构成的结构,而部件自身又由部件构成,如此层层递进。
>>> dog = [['head', ['face', ['nose', 'eyes']], ['ears']],
           ['body', ['legs', ['paws']]],
           'tail']
>>> dog[0]
['head', ['face', ['nose', 'eyes']], ['ears']]
在环境图中,我们可以用**盒指针记法(box-and-pointer notation)**来直观表示列表。列表被画成一排相邻的方格,里面盛着列表的各项。数字、字符串、布尔值与 None 这类基本值就写在方格内;而函数值、其他列表这类复合值,则用箭头表示。
one_two = [1, 2]
nested = [[1, 2], [],
          [[3, False, None],
           [4, lambda: 5]]]
序列迭代
许多时候,我们想要遍历序列的各项,依次对每一项做某种计算。这一模式如此常见,以至于 Python 专为处理序列数据增设了一条控制语句:for 语句。
考虑这样一个问题:数一数某个值在序列中出现了多少次。我们可以用 while 循环实现一个函数来计算这个计数:
>>> def count(s, value):
        """Count the number of occurrences of value in sequence s."""
        total, index = 0, 0
        while index < len(s):
            if s[index] == value:
                total = total + 1
            index = index + 1
        return total
>>> count(digits, 8)
2
Python 的 for 语句能简化这个函数体:直接遍历各项的值,全然不必引入名字 index。
>>> def count(s, value):
        """Count the number of occurrences of value in sequence s."""
        total = 0
        for item in s:
            if item == value:
                total = total + 1
        return total
>>> count(digits, 8)
2
for 语句由单个子句构成,形如:
for <name> in <expression>:
    <suite>
for 语句按如下流程执行:
- 求值头部
<expression>,它必须得出一个可迭代值(iterable value); - 对那个可迭代值中的每个项值,依次:A. 在当前帧中把
<name>绑定到该项值;B. 执行<suite>。
这套执行流程提到了可迭代值。列表是一种序列,而序列都是可迭代值——它们的各项按顺序被逐一考察。Python 还包含其他可迭代类型,但眼下我们只关注序列;「可迭代」一词的一般定义,见 2.8 节。
这条求值流程的一个重要推论是:for 语句执行完毕后,<name> 会绑定到序列的最后一个项(除非序列为空)。for 循环为「语句可以更新环境」提供了又一种方式。
序列解包
程序中有一种常见的模式:一个序列的各项本身也是序列,而且长度固定。for 语句的头部可以包含多个名字,从而把每个项序列「解包」到各自的各项中。例如,我们可能有一个由二元列表组成的列表
>>> pairs = [[1, 2], [2, 2], [2, 3], [4, 4]]
并且想找出其中首项与次项相同的数对有多少个。
>>> same_count = 0
下面这条头部带两个名字的 for 语句,会把 x 与 y 分别绑定到每一对中的第一项与第二项。
>>> for x, y in pairs:
        if x == y:
            same_count = same_count + 1
>>> same_count
2
这种把多个名字绑定到定长序列中多个值的模式,称为序列解包(sequence unpacking);这与我们在赋值语句中把多个名字绑定到多个值所见的是同一种模式。
range
Range 是 Python 中另一种内置的序列类型,表示一段整数区间。Range 用 range 创建,它接受两个整数实参:期望区间的第一个数,以及最后一个数再往后一个。
>>> range(1, 10)  # 包含 1,但不包含 10
range(1, 10)
对 range 施加 list 构造器,会求值为一个各项与 range 相同的列表,便于查看各项。
>>> list(range(5, 8))
[5, 6, 7]
若只给一个实参,它被理解为「从 0 开始、到该值再往后一个为止」的区间终点。
>>> list(range(4))
[0, 1, 2, 3]
Range 常出现在 for 头部,用来指定子句组应执行的次数。一个常见的惯例是:若名字在子句组中并不使用,就用单个下划线字符作 for 头部的名字。
>>> for _ in range(3):
        print('Go Bears!')
Go Bears!
Go Bears!
Go Bears!
在解释器看来,这个下划线不过是环境中的又一个名字;但在程序员之间,它是一种约定俗成的记号,表示这个名字不会出现在今后的任何表达式中。
序列处理
序列是如此常见的一种复合数据形式,以至于整个程序常常围绕这单一的抽象来组织。以序列为输入、又以序列为输出的模块化组件,可以自由搭配,完成数据处理。把一串简单的序列处理操作——每一项都单纯而专注——连成流水线,便能定义出复杂的组件。
列表推导式
许多序列处理操作,都可以这样表达:对序列中的每一项求值某个固定的表达式,再把所得的各值收集成一个结果序列。在 Python 中,**列表推导式(list comprehension)**正是执行这类计算的表达式。
>>> odds = [1, 3, 5, 7, 9]
>>> [x+1 for x in odds]
[2, 4, 6, 8, 10]
上面这个 for 关键字并不是 for 语句的一部分,而是列表推导式的一部分,因为它处于方括号之内。子表达式 x+1 依次在 x 绑定到 odds 的每一项时求值,所得各值被收集成一个列表。
另一种常见的序列处理操作,是选出满足某个条件的值的子集。列表推导式也能表达这个模式,例如选出 odds 中能整除 25 的所有项。
>>> [x for x in odds if 25 % x == 0]
[1, 5]
列表推导式的一般形式是:
[<map expression> for <name> in <sequence expression> if <filter expression>]
要求值一个列表推导式,Python 先求值 <sequence expression>,它必须返回一个可迭代值。然后,按顺序对每一项:把项值绑定到 <name>,求值过滤表达式(若有),若它求值为真值(或根本没有过滤),就求值映射表达式。映射表达式所得的各值被收集成一个列表。
聚合
序列处理中的第三种常见模式,是把序列中的所有值**聚合(aggregate)**为单个值。内置函数 sum、min、max 都是聚合函数的例子。
把「对每一项求值一个表达式」「选出项的子集」「聚合各项」这三种模式结合起来,我们便能以序列处理的方式来解决问题。
**完全数(perfect number)**是等于其各因数之和的正整数。n 的因数是小于 n、且能整除 n 的正整数。列出 n 的各个因数,可以用列表推导式表达:
>>> def divisors(n):
        return [1] + [x for x in range(2, n) if n % x == 0]
>>> divisors(4)
[1, 2]
>>> divisors(12)
[1, 2, 3, 4, 6]
借助 divisors,再用一个列表推导式,便能算出 1000 以内的所有完全数。(range 从 2 开始,因为 divisors(1) 是 [1],其和为 1,而 1 并不算完全数。)
>>> [n for n in range(2, 1000) if sum(divisors(n)) == n]
[6, 28, 496]
我们还可以复用 divisors 的定义,去解决另一个问题:已知矩形的面积,求边长为整数时最小的周长。矩形的面积是长乘宽,因此已知面积与高,便可算出宽。我们可以断言高能整除面积,以确保边长都是整数。
>>> def width(area, height):
        assert area % height == 0
        return area // height
矩形的周长是其各边长之和。
>>> def perimeter(width, height):
        return 2 * width + 2 * height
边长为整数的矩形,它的高必定是面积的因数。把所有可能的高都考察一遍,即可算出最小周长。
>>> def minimum_perimeter(area):
        heights = divisors(area)
        perimeters = [perimeter(width(area, h), h) for h in heights]
        return min(perimeters)
>>> area = 80
>>> width(area, 5)
16
>>> perimeter(16, 5)
42
>>> perimeter(10, 8)
36
>>> minimum_perimeter(area)
36
>>> [minimum_perimeter(n) for n in range(1, 10)]
[4, 6, 8, 8, 12, 10, 16, 12, 12]
类型提示。 我们可以指明某个形式参数或返回值是列表,并且指明它是各项类型相同的列表。例如,类型提示 list[int] 表示某名字应当用于一个整数列表。
描述 [[1, 2], [3, 4], [5, 6]] 的类型提示应写作 list[list[int]],因为它是「整数列表的列表」。至于每个子列表恰好含两个整数这一点,Python 的列表类型提示无从规定。
>>> def divisible_by(s: list[int], k: int) -> list[int]:
        "The items in s that are divisible by k."
        return [n for n in s if n % k == 0]
>>> divisible_by([3, 4, 5, 6, 7, 8], 4)
[4, 8]
高阶函数
我们在序列处理中观察到的这些常见模式,都可以用高阶函数来表达。首先,对序列中的每一项求值某个表达式,可以表达为「把一个函数施加于每一项」。
>>> def apply_to_all(map_fn, s):
        return [map_fn(x) for x in s]
只选出使某个表达式为真的那些项,可以表达为「把一个函数施加于每一项」。
>>> def keep_if(filter_fn, s):
        return [x for x in s if filter_fn(x)]
最后,许多形式的聚合,都可以表达为「把双参数函数反复施加于目前的归约值与每一项」。
>>> def reduce(reduce_fn, s, initial):
        reduced = initial
        for x in s:
            reduced = reduce_fn(reduced, x)
        return reduced
以 mul 作为 reduce_fn、以 1 为初始值,reduce 便可用来把一串数字依次相乘。
>>> from operator import mul
>>> reduce(mul, [2, 4, 8], 1)
64
用这些高阶函数,同样能找出完全数。
>>> def divisors_of(n):
        divides_n = lambda x: n % x == 0
        return [1] + keep_if(divides_n, range(2, n))
>>> divisors_of(12)
[1, 2, 3, 4, 6]
>>> from operator import add
>>> def sum_of_divisors(n):
        return reduce(add, divisors_of(n), 0)
>>> def perfect(n):
        return sum_of_divisors(n) == n
>>> keep_if(perfect, range(2, 1000))
[6, 28, 496]
习惯叫法。 在计算机科学界,apply_to_all 更常见的名字是 map,keep_if 更常见的名字是 filter。在 Python 中,内置的 map 与 filter 是这两个函数的推广版本,它们并不返回列表——这些函数将在 2.8 节讨论。上面的 apply_to_all 与 keep_if,等价于对内置 map、filter 调用的结果施加 list 构造器。
>>> apply_to_all = lambda map_fn, s: list(map(map_fn, s))
>>> keep_if = lambda filter_fn, s: list(filter(filter_fn, s))
reduce 函数内置在 Python 标准库的 functools 模块中。在那个版本里,初始值实参是可选的。
>>> from functools import reduce
>>> from operator import mul
>>> def product(s):
        return reduce(mul, s)
>>> product([1, 2, 3, 4, 5])
120
在 Python 程序中,直接使用列表推导式比使用高阶函数更为常见,但这两条序列处理的路径都被广泛采用。
序列抽象
我们已经介绍了两种满足本节开篇所提条件(长度与取项)的原生数据类型。Python 还包含序列类型的另外两种行为,它们拓展了序列抽象。
成员资格(Membership)。 可以检验某个值是否属于某序列。Python 有 in 与 not in 两个运算符,依据某项是否出现在序列中,求值为 True 或 False。
>>> digits
[1, 8, 2, 8]
>>> 2 in digits
True
>>> 1828 not in digits
True
切片(Slicing)。 序列中包含着更小的序列。序列的切片,是原序列中任意一段连续的跨度,由一对整数指定。与 range 构造器一样,第一个整数表示切片的起始下标,第二个表示结束下标再往后一个。
在 Python 中,序列切片的写法与取项相似,同样使用方括号,用冒号分隔起止下标。任何被省略的边界都默认取极值:起始下标默认为 0,结束下标默认为序列长度。
>>> digits[0:2]
[1, 8]
>>> digits[1:]
[8, 2, 8]
把 Python 序列抽象的这几种额外行为一一罗列出来,正好给我们一个机会,去思考「什么才构成有用的数据抽象」这个一般问题。一种抽象的丰富程度(即它包含多少种行为)是有后果的:对抽象的使用者而言,行为多一些自有裨益;可另一面,复杂的抽象也让用户学起来更费时日。
序列拥有丰富的抽象(长度、取项、成员资格、切片),是因为它们在计算中无处不在,花些功夫学会几种复杂行为是值得的。总的来说,大多数用户自定义的抽象,应当尽量保持简单。
延伸阅读。 切片记法容许种种特殊情形,比如起始值与结束值取负、以及指定步长。完整的描述见 Dive Into Python 3 中「slicing a list」一小节。本章只使用上文所述的基本特性。
字符串
对于计算机科学而言,文本值或许比数字更为根本。Python 程序本身就是以文本编写和存储的。Python 中表示文本的原生数据类型称为字符串(string),对应构造器 str。
关于字符串在 Python 中如何表示、如何表达、如何操作,细节繁多。字符串是「丰富抽象」的又一例——要掌握它,程序员必须在相当程度上投入心力。本节提供一份关于字符串基本行为的浓缩导引。
字符串字面量可以表达任意文本,用单引号或双引号括起来即可。
>>> 'I am string!'
'I am string!'
>>> "I've got an apostrophe"
"I've got an apostrophe"
>>> '您好'
'您好'
我们早已在代码中见过字符串——作为文档字符串,作为 print 调用的实参,以及 assert 语句中的错误信息。
字符串满足本节开头介绍的序列的两个基本条件:有长度,且支持取项。
>>> city = 'Berkeley'
>>> len(city)
8
>>> city[3]
'k'
字符串的各项,本身就是只含单个字符的字符串。一个**字符(character)**可以是字母表中的任意单个字母、标点符号或其他符号。与许多其他编程语言不同,Python 没有单独的字符类型;任何文本都是字符串,而表示单个字符的字符串长度为 1。
和列表一样,字符串也可以通过加法与乘法来组合。
>>> 'Berkeley' + ', CA'
'Berkeley, CA'
>>> 'Shabu ' * 2
'Shabu Shabu '
成员资格。 字符串的行为在 Python 中与其他序列类型分道扬镳。字符串抽象并不完全符合我们为列表与 range 所描述的那套完整序列抽象。尤其是:成员资格运算符 in 虽然也适用于字符串,但其行为与其他序列截然不同——它匹配的是子串(substrings),而非各项。
>>> 'here' in "Where's Waldo?"
True
多行字面量。 字符串并不局限于一行。三引号可以界定跨越多行的字符串字面量。我们早已为文档字符串大量使用过三引号。
>>> """The Zen of Python
claims, "Readability counts."
Read more: import this."""
'The Zen of Python\nclaims, "Readability counts."\nRead more: import this.'
在上面的打印结果中,\n(读作「反斜杠 n」)是代表换行的单个项。它虽然看起来是两个字符(反斜杠与 n),但就长度与取项而言,它被当作单个字符。
字符串强制转换。 在 Python 中,以某个对象值为实参调用 str 构造器函数,便可根据任意对象创建字符串。这一特性对于从各种类型的对象构造描述性字符串颇为有用。
>>> str(1 + 1) + ' is an item of ' + str(digits)
'2 is an item of [1, 8, 2, 8]'
字符串插值(String interpolation)。 还可以把各表达式值的字符串表示插入一个更大的模板中,从而创建字符串,这种模板称为 f-string 或格式化字符串字面量(formatted string literal)。在字符串字面量前面加上字母 f,即指示 Python 求值花括号内所包含的一切表达式,并把它们值的字符串表示嵌入其中。
>>> f'{1 + 1} is an item of {digits}'
'2 is an item of [1, 8, 2, 8]'
延伸阅读。 在计算机中编码文本,是个复杂的话题。本章将字符串如何表示的细节抽象掉了。然而对许多应用而言,计算机如何编码字符串这一具体细节,却是必备知识。Dive Into Python 3 的字符串一章描述了字符编码与 Unicode;Python 教程中关于 f-string 的一节,则介绍了指定值格式的种种方法。
字典
**字典(dictionary)是 Python 内置的、用于存储与操作映射关系的数据类型。字典是键值对(key-value pairs)**的有序集合。字典的用意,是为「不按连续整数、而按描述性的键来查找」提供一种抽象,以便存储与取回值。
字符串常被用作键,因为字符串是我们指称事物名字的惯用表示。下面这个字典字面量给出了若干罗马数字的值。
>>> numerals = {'I': 1, 'V': 5, 'X': 10}
>>> numerals
{'I': 1, 'V': 5, 'X': 10}
>>> len(numerals)
3
按各键查找值,用的是我们先前施加于序列的取项运算符。
>>> numerals['X']
10
一个字典中,每个键至多对应一个值。键值对的顺序由各键首次出现的顺序决定,但只保留最后那个值。
>>> {'X': 11, 'V': 5, 'X': 10}
{'X': 10, 'V': 5}
字典的键不能是列表或另一个字典(更一般地说,不能是任何其他**不可哈希(unhashable)**的值)。这一限制与 Python 中字典的底层实现有关。
字典也支持遍历其键值对的种种方式。最简单的做法,是用 for 语句遍历各键。
>>> for k in numerals:
        print('key:', k, 'value:', numerals[k])
key: I value: 1
key: V value: 5
key: X value: 10
同样地,也可以创建由字典各键组成的列表。
>>> list(numerals)
['I', 'V', 'X']
字典也可以出现在环境图中。
numerals = {'I': 1, 'V': 5, 'X': 10}
字典的类型提示可以只写 dict,也可以分别指明键的类型与值的类型。例如,描述 numerals 字典的类型提示应写作 dict[str, int]。
点记法
使用点表达式(dot expression),还可以遍历字典的各值或各键值对。点表达式是访问复合数据的各部分、或访问特定于该值类型的行为的一种方式。点记法的诸多细节将在 2.5 节讨论面向对象编程时展开。眼下只需知道:.values() 访问字典的各值,.items() 访问各键值对。它们称为字典的方法(methods)。
>>> for v in numerals.values():
        print(v)
1
5
10
>>> for k, v in numerals.items():
        print(k, v)
I 1
V 5
X 10
字典上另一个有用的方法是 get:若键存在则返回其值,否则返回一个默认值。get 的实参是键与默认值。
>>> numerals.get('A', 0)
0
>>> numerals.get('V', 0)
5
由键值对组成的列表,可以通过调用 dict 转换为字典。
>>> dict([[3, 9], [4, 16], [5, 25]])
{3: 9, 4: 16, 5: 25}
字典也有与列表类似的推导式语法:键表达式与值表达式以冒号分隔。求值一个字典推导式,会创建一个新的字典对象。
>>> {x: x*x for x in range(3,6)}
{3: 9, 4: 16, 5: 25}
元组
元组(tuple)是一种可以作为字典键的序列(前提是元组中不含列表、字典之类不被允许的值)。元组用元组字面量创建,各项表达式以逗号分隔。圆括号是可选的,但实践中几乎总会写上。任何值都可以放进元组。
>>> 1, 2 + 3
(1, 5)
>>> ("the", 1, ("and", "only"))
('the', 1, ('and', 'only'))
>>> type( (10, 20) )
<class 'tuple'>
空元组与单元素元组有特殊的字面量语法。
>>> ()    # 0 项
()
>>> (10,) # 1 项
(10,)
与列表一样,元组具有有限长度,支持取项、切片与成员资格检验。其各项也可以用赋值解包。
>>> code = ('up', 'up', 'down', 'down') + ('left', 'right') * 2
>>> len(code)
8
>>> code[3]
'down'
>>> 'left' in code
True
>>> code[1:3]
('up', 'down')
>>> u, d = code[1:3]
>>> u
'up'
>>> d
'down'
元组的类型提示可以逐一指明每个位置上的值类型,因为元组常用于盛放多种类型。下面这个例子中含有一个类型提示 tuple[str, int],表示一个二元组,先是一个 str,然后是一个 int。这种类型提示的格式与列表的类型提示不同——后者只能为列表中所有项指明一个共同的类型。因此,元组的类型提示可以指明元组的长度,而列表的类型提示则不能。
>>> def display_age(person: tuple[str, int], year: int) -> None:
        name, year_born = person
        print(name, 'was', year - year_born, 'years old in', year)
>>> keanu = ("Keanu Reeves", 1964)
>>> display_age(keanu, 1999)
Keanu Reeves was 35 years old in 1999
若字典需要复合的键,元组是常见之选。下面这个字典,用出生年份来区分篮球运动员 Michael Jordan 与演员 Michael B. Jordan。
>>> top_movies = {
        ('Michael Jordan', 1963): 'Space Jam',
        ('Michael Jordan', 1987): 'Black Panther',
    }
>>> top_movies[('Michael Jordan', 1963)]
'Space Jam'
若要精确描述 top_movies 字典,类型提示应写作 dict[tuple[str, int], str]——它说明键是二元组,值是字符串。
译者注:2.1 中的类型别名、类型变量语法需要 Python 3.12 及以上版本。
2.3 复合数据
当我们考虑世间形形色色、想要在程序中加以表示的事物时,会发现其中大多数都具有复合结构。例如,一个地理位置有纬度与经度坐标;一个日期有年、月、日。为表示位置、日期这类概念而引入专门的类型,已被证明是组织复杂程序的一种极佳方式。
对象隐喻
**对象(object)**把值与行为结合起来。对象的中心特征在于:它们既表示信息,又表现得如同它们所表示的信息。当一个对象被打印时,它提供描述自身的文本;若一个对象是若干部件的组合,它便提供对这些部件的访问。对象既是信息,又是功能,二者捆绑在一起,以提供抽象的表示。
在 Python 中,一切值都是对象。数据不再只是由函数操作的数字,而是具有类型的对象,类型赋予了这些对象各种行为。Python 的 date 类型提供了一个绝佳的说明。程序固然可以用一个整数列表(年、月、日)来表示日期,但 date 对象却把大量与日期相关的功能一并打包了进来。
>>> from datetime import date
>>> date
<class 'datetime.date'>
>>> final = date(2026, 12, 18)
>>> final
datetime.date(2026, 12, 18)
名字 date 绑定到一个类(class),它代表一种值。一个个具体的日期,称为该类的实例(instances)或对象。实例通过「以描述该实例的实参调用类」来构造。
final 虽然是由基本数字构造出来的,举止却如同一个日期。例如,用另一个日期减去它,便得到一段时差,我们可以把它打印出来。
>>> print(date(2026, 12, 21) - final)
3 days, 0:00:00
对象具有属性(attributes),即作为对象一部分的具名值。在 Python 中(一如许多其他编程语言),我们用点记法指明对象的某个属性。
<expression> . <name>
其中 <expression> 求值为一个对象,<name> 是该对象某个属性的名字。
属性名在全局环境中并不存在;它们专属于点号之前的那个对象实例。
>>> final.year
2026
>>> final.day
18
对象还有方法(methods),即取值为函数的属性。打个比方,我们说对象「知道」如何执行那些方法。从实现上说,方法是这样的函数:其结果同时由其实参与其所属对象计算得出。例如,final 的 strftime 方法(「string format of time」的缩写)接受单个实参,指明如何显示日期(例如 %A 表示把星期几完整拼写出来)。
>>> final.strftime('%A, %B %d')
'Friday, December 18'
计算 strftime 的返回值需要两项输入:描述输出格式的字符串,以及捆绑在 final 中的日期信息。该方法内部施用日期特有的逻辑,从而得出这个结果。我们从未告诉过它 2026 年 12 月 18 日是星期五;然而,知道与之对应的星期几,本就是「一个日期」应有之义的一部分。通过把行为与信息捆绑在一起,这个 Python 对象为我们提供了一个令人信服、自成一体的日期抽象。
日期是对象,但数字、字符串、列表与 range 同样都是对象。它们表示值,同时也以与其所表示的值相称的方式行事。它们也有属性与方法。例如,字符串就有若干便于文本处理的方法。
>>> '1234'.isnumeric()
True
>>> 'rOBERT dE nIRO'.swapcase()
'Robert De Niro'
>>> 'eyes'.upper().endswith('YES')
True
数据类
要把位置表示为对象,我们希望编程语言能够引入一个新的类——Position,它把一个纬度与一个经度耦合为一个复合对象;我们的程序可以把它当作单一的概念单元来操作,同时又能用点表达式访问其中的两个坐标。
我们本可以用一个二元列表来表示位置,但这样一来,凡是要访问其坐标之处,都得记住纬度在前还是经度在前。
我们也可以改用带 dataclass 装饰器的 class 语句,创建一个带有 lat 与 lon 属性的 Position 类型。class 语句用来创建新的用户自定义类型;class 语句的更多细节将在 2.5 节讨论面向对象编程时展开。dataclass 装饰器简化了为复合数据创建类的工作。class 头部之下缩进的那些行声明:每个 Position 对象都有 lat 与 lon 两个属性,二者都应当是数字。
from dataclasses import dataclass

@dataclass
class Position:
    "A geographic position."
    lat: float
    lon: float
这条 class 语句一经执行,便可对一对数字调用 Position,创建出新的 Position 对象。位置的坐标用点表达式访问。
>>> sydney = Position(-33.87, 151.21)
>>> sydney.lat
-33.87
>>> sydney.lon
151.21
>>> sydney
Position(lat=-33.87, lon=151.21)
>>> type(sydney) == Position
True
>>> isinstance(sydney, Position)
True
定义一个接受 Position、返回 str 的函数,便能把一个位置格式化,附上方位(N、S、E、W)。[1]
>>> def format_pos(p: Position) -> str:
        "Format the position as a string with directional suffixes."
        assert abs(p.lat) <= 90 and abs(p.lon) <= 180, f'{p!r} is not on Earth!'
        if p.lat >= 0:
            lat_dir = "N"
        else:
            lat_dir = "S"
        if p.lon >= 0:
            lon_dir = "E"
        else:
            lon_dir = "W"
        return f"{abs(p.lat)}° {lat_dir}, {abs(p.lon)}° {lon_dir}"
>>> format_pos(sydney)
'33.87° S, 151.21° E'
我们还可以重新定义 Position 类,让它包含一个 __str__ 方法——就是在类内部定义的一个函数。这个特殊的名字 __str__ 指示 Python:每当任何 Position 被打印或传给 str 时,就调用 format_pos。如何为类添加行为的完整描述,见 2.5 节面向对象编程。眼下我们只关注一点:确保用户自定义的数据类型在被打印时能提供有用的信息。
@dataclass
class Position:
    "A geographic position."
    lat: float
    lon: float
    def __str__(self):
        return format_pos(self)

sydney = Position(-33.87, 151.21)
>>> str(sydney)
'33.87° S, 151.21° E'
>>> print('The position of Sydney is', sydney)
The position of Sydney is 33.87° S, 151.21° E
数据抽象
在继续给出用户自定义类型的更多例子之前,值得先审视一下抽象在位置这个例子中所扮演的角色。通过定义一个类,我们可以使用一个 Position——访问其具名属性(lat 与 lon),或把它打印出来——而无需指定或决定其基本组件是如何存储、如何组合的。若不动用 class 语句,我们就得决定位置是用列表、字典还是别的什么来表示;而且每回想打印一个位置,都得调用 format_pos。
事实上,我们所用过的所有原生类也都是抽象。Python 列表自有其存储与组合各项的方式,但我们使用一个列表——访问其长度与各项——却无需推敲它在计算机内存中的表示。我们可以打印一个列表,而不必思量构造其打印表示的过程。同样地,字典与字符串也都是抽象:它们让我们得以与复合数据打交道,同时把「字典究竟如何按键查找值」「字符串如何表示诸多不同字母表中的字母」这类细节抽象掉。甚至 int 与 float 类型也是抽象——它们让我们处理数字,而不必时刻推敲计算机的晶体管是如何存储数字的。
**数据抽象(data abstraction)**意味着:为一种数据赋予名字,并依照一套固定的、专属于该数据类型的操作来与复合数据值打交道,而不对「这些操作如何实现」作任何假设或推理。这与函数抽象相类似——函数抽象为某个计算过程赋予名字,然后(通过调用函数)使用它,而不对「该过程如何实现」作假设或推理。
最终去了解数据抽象的种种实现,既有趣,也对打造有用的软件至关重要。但学会以抽象的方式处理数据,同样大有裨益。老练的程序员不仅懂得数字、列表、字典与类是如何实现的,也学会了使用这些对象而不必时刻惦记其实现。对象这一概念——被许多编程语言所共有——其设计初衷,正是帮助我们将复合数据的使用与实现分隔开来。
链表
到目前为止,我们只用原生类型来表示序列。然而,我们也可以开发出并非 Python 内置的序列表示。例如,一种常见而有用的序列表示是链表(linked list)。
链表把一个序列的首项与其余部分结合起来。链表具有递归结构:链表的其余部分又是一个链表。仅用二元组就能表示链表,并用空元组表示空链表。如此一来便可看到:任何组合两个值的方法,都可用于表示任意长度的序列。
s = (9, (7, (5, (3, ()))))
链表之所以不同于二元组,在于其规整的结构:每个首项类型相同,每个次项又是另一个链表。我们可以用一个针对链表的数据类来表达这种结构。
type LinkedList[T] = Link[T] | tuple[()]

@dataclass
class Link[T]:
    "A Link has a first value of type T and the rest of the linked list."
    first: T
    rest: LinkedList[T] = ()  # rest 默认为空链表
类型 tuple[()] 只有一个相容的值:空元组。
下面的例子演示如何构造一个含数字 3、4、5 的链表,以及如何用 first 与 rest 属性访问其各项。
>>> s = Link(3, Link(4, Link(5)))
>>> s.first
3
>>> s.rest.first
4
>>> s.rest.rest.first
5
>>> s.rest.rest.rest == ()
True
>>> s
Link(first=3, rest=Link(first=4, rest=Link(first=5, rest=())))
>>> s.rest.rest
Link(first=5, rest=())
显示链表并没有唯一的标准化写法,但一种常见的做法是把所含各项放在圆括号内、不带逗号地显示出来。这种记法由 Lisp 编程语言引入——那是最古老且至今仍被广泛使用的语言之一。
给 Link 类添加一个 __str__ 方法,便能在每次 Link 对象被打印或传给 str 时生成这种字符串表示。
def format_link(s: Link):
    """Return a Link s formatted as items within parentheses."""
    string = '(' + str(s.first)
    remaining = s.rest
    while isinstance(remaining, Link):
        string += ' ' + str(remaining.first)
        remaining = remaining.rest
    assert remaining == (), f'{s!r} is not a LinkedList'
    return string + ')'

@dataclass
class Link[T]:
    "A Link has a first value of type T and the rest of the linked list."
    first: T
    rest: LinkedList[T] = ()  # rest 默认为空链表
    def __str__(self):
        return format_link(self)

s = Link(3, Link(4, Link(5)))
>>> print(s)
(3 4 5)
完整的 Link 类见示例附录。
要直观表示任何链表(无论是由元组还是数据类创建),最常见的办法是使用盒指针图:每个 Link 画成一对方格,分别盛着它的 first 与 rest;链表最后一个 Link 的 rest 处画一道斜杠,表示空表。下图是 Link(3, Link(4, Link(5))) 的示意图,它会被打印为 (3 4 5)。
下面两个示例函数接受链表:len_link 返回链表中含有的项数,getitem_link 按位置返回某一项。
>>> def len_link(s: LinkedList):
"""Return the length of a linked list."""
length = 0
while isinstance(s, Link):
length += 1
s = s.rest
return length
>>> len_link(s)
3
>>> def getitem_link(s: LinkedList, i: int):
"""Return the item at index i of a non-empty linked list."""
while i > 0:
assert isinstance(s, Link), 'Index out of range'
s = s.rest
i -= 1
assert isinstance(s, Link), 'Index out of range'
return s.first
>>> getitem_link(s, 1)
4
类型变量。 与列表一样,LinkedList 通常盛放着类型相同的各项。LinkedList[T] 与 Link[T] 类型带有一个类型变量 T,表示其所含各项共享的同一类型。T 可以被任何类型替换。例如,LinkedList[int] 描述一个所有项都是 int 值的 LinkedList。接受或返回链表的函数,可以按需指明这些列表中所含各项的类型。
>>> def sum_link(s: LinkedList[float]) -> float:
"""Return the sum of the items in a linked list of numbers."""
total = 0
while isinstance(s, Link):
total += s.first
s = s.rest
return total
>>> sum_link(s)
12
这些例子展示了一种处理链表的常见计算模式:迭代中的每一步,都作用于原列表越来越短的后缀。
递归处理。 len_link、getitem_link 与 sum_link 都是迭代式的:它们逐个剥去 Link,直到抵达列表末尾(len_link 与 sum_link)或所求的那一项(getitem_link)。这三个函数也都可以用递归来实现。
>>> four = Link(1, Link(2, Link(3, Link(4))))
>>> print(four)
(1 2 3 4)
>>> def len_link_recursive(s: LinkedList) -> int:
"""Return the length of a linked list s."""
if not isinstance(s, Link):
return 0
return 1 + len_link_recursive(s.rest)
>>> len_link_recursive(four)
4
>>> def getitem_link_recursive(s: LinkedList, i: int):
"""Return the item at index i of linked list s."""
assert isinstance(s, Link), 'Index out of range'
if i == 0:
return s.first
return getitem_link_recursive(s.rest, i - 1)
>>> getitem_link_recursive(four, 1)
2
>>> def sum_link_recursive(s: LinkedList[float]) -> float:
"""Return the sum of the items in a linked list of numbers."""
if not isinstance(s, Link):
return 0
return s.first + sum_link_recursive(s.rest)
>>> sum_link_recursive(s)
12
递归在变换与合并链表时同样有用。
>>> def extend_link(s: LinkedList, t: LinkedList) -> LinkedList:
"""Return a linked list with the items of s followed by those of t."""
if not isinstance(s, Link):
return t
else:
return Link(s.first, extend_link(s.rest, t))
>>> print(extend_link(four, four))
(1 2 3 4 1 2 3 4)
>>> def apply_to_all_link(f, s: LinkedList) -> LinkedList:
"""Return a linked list of f applied to each item of s."""
if not isinstance(s, Link):
return s
else:
return Link(f(s.first), apply_to_all_link(f, s.rest))
>>> print(apply_to_all_link(lambda x: x*x, four))
(1 4 9 16)
>>> def keep_if_link(f, s: LinkedList) -> LinkedList:
"""Return a linked list with the items of s for which f returns a true value."""
if not isinstance(s, Link):
return s
else:
kept = keep_if_link(f, s.rest)
if f(s.first):
return Link(s.first, kept)
else:
return kept
>>> print(keep_if_link(lambda x: x%2 == 0, four))
(2 4)
>>> def join_link(s: LinkedList, separator: str) -> str:
"""Return a string of all items in s separated by separator."""
if not isinstance(s, Link):
return ""
elif not isinstance(s.rest, Link):
return str(s.first)
else:
return str(s.first) + separator + join_link(s.rest, separator)
>>> print(join_link(four, ", "))
1, 2, 3, 4
递归构造。 在逐步构造序列时,链表格外有用——而这种情形在递归计算中屡见不鲜。
第 1 章的 count_partitions 函数通过树递归过程,计算了「用不超过 m 的部分划分整数 n」的方法数。有了序列,我们还可以用类似的流程把这些划分显式地枚举出来。
我们对问题作与计数时相同的递归分析:用不超过 m 的整数划分 n,涉及
- 用不超过 m 的整数划分 n−m,或者
- 用不超过 m−1 的整数划分 n。
至于基准情形:0 有一种划分,即空划分;而划分负整数,或用小于 1 的部分来划分,则是不可能的。
>>> def partitions(n: int, m: int) -> list[LinkedList[int]]:
"""Return a list of partitions of n using parts of up to m.
Each partition is represented as a linked list.
"""
if n == 0:
return [()] # 含空划分的列表
elif n < 0 or m == 0:
return []
else:
with_m = [Link(m, s) for s in partitions(n-m, m)]
without_m = partitions(n, m-1)
return with_m + without_m
在递归情形中,我们构造两个划分的子列表。第一个用到 m,于是把 m 前插到递归调用 partitions(n-m, m) 所返回的每一个项上,构成 with_m。这里使用链表比使用原生 Python 列表更高效,因为前插只需构造一个新的 Link。
partitions 的结果是一个(常规 Python)列表,其中含若干链表。借助 join_link,我们可以用人类可读的方式显示每一种划分。
>>> def print_partitions(n: int, m: int) -> None:
"Print the partitions of n using parts up to size m."
for p in partitions(n, m):
print(join_link(p, " + "))
>>> print_partitions(6, 4)
4 + 2
4 + 1 + 1
3 + 3
3 + 2 + 1
3 + 1 + 1 + 1
2 + 2 + 2
2 + 2 + 1 + 1
2 + 1 + 1 + 1 + 1
1 + 1 + 1 + 1 + 1 + 1
嵌套链表。 链表中的首项可以是任何对象,包括另一个链表。把链表放进链表之中,便能造出嵌套结构,而盒指针图正适合直观表示这类结构。下图是 Link(Link(3, Link(Link(4))), Link(Link(5, Link(6)), Link(7))) 的示意图,它会被打印为 ((3 (4)) (5 6) 7)。
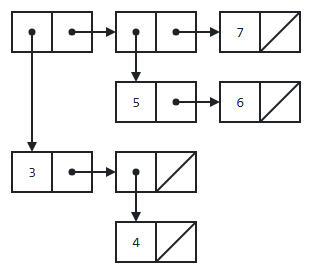
树
在列表之中嵌套列表,是构造层次结构的一种方式;而**树(tree)**则是一种基本的数据抽象,它为层次值如何组织与操作规定了规整的章法。
一棵树有一个根标签(root label)(可以是任何值)以及一序列分支(branches)。树的每一个分支都是一棵树。没有分支的树称为叶(leaf)。树中所包含的任何树,都称为该树的子树(sub-tree)(比如某分支的分支)。一棵树的每棵子树的根,都称为该树的节点(node)。
下面是一个简单的 Tree 数据类。
from __future__ import annotations # Python 3.12 与 3.13 需要
from dataclasses import field
@dataclass
class Tree[T]:
"A Tree has a label (of type T) and a list of branches, which are trees."
label: T
branches: list[Tree[T]] = field(default_factory=list) # branches 默认为 []
对 Python 3.12 与 3.13 而言,在这条定义之前执行 from __future__ import annotations 是必要的,这样才能用这种类型提示语法让一棵 Tree 含有 list[Tree[T]] 属性。到 Python 3.14 及以后,这个导入就不需要了。
那个复杂的表达式 field(default_factory=list) 之所以必要,是因为要为空列表属性 branches 提供一个默认值,而不能简单地写 []——这涉及 2.4 节将要讨论的**变异(mutation)**概念。这个表达式确保每一片叶子都有自己独立的空分支列表,而不是与其他 Tree 对象共享同一个列表。
树可以用嵌套表达式来构造。下面这个 Tree 对象 t 的根标签是 3,有两个分支。
>>> t = Tree(3, [Tree(1), Tree(2, [Tree(1), Tree(1)])])
>>> t.branches[0]
Tree(label=1, branches=[])
>>> len(t.branches)
2
>>> t.branches[1].label
2
>>> len(t.branches[1].branches)
2
这里引入一种字符串表示:把树中的所有标签显示出来,并按各标签在树的分支中所处的深度加以缩进。Tree 类新增的 __str__ 方法确保每次 Tree 对象被打印或传给 str 时都会调用 format_tree。
def format_tree(t: Tree, indent='') -> str:
"Format a tree with each branch indented below its label."
assert isinstance(t, Tree), f'{t!r} is not a Tree'
assert isinstance(t.branches, list), f'branches of {t!r} is not a list'
string = indent + str(t.label)
for b in t.branches:
string += '\n' + format_tree(b, indent + ' ')
return string
@dataclass
class Tree[T]:
"A Tree has a label (of type T) and a list of branches, which are trees."
label: T
branches: list[Tree[T]] = field(default_factory=list) # branches 默认为 []
def __str__(self):
return format_tree(self)
is_leaf 函数接受一棵 Tree,返回它是否为叶,读起来一目了然:
def is_leaf(t: Tree) -> bool:
"Return whether a Tree t is a leaf with no branches."
return not t.branches
完整的 Tree 类见示例附录。
下面的例子构造一棵树,表示表达式 ((2 * 3) + 4) 的求值过程。
>>> expr = Tree(10, [Tree(6, [Tree(2), Tree('*'), Tree(3)]), Tree('+'), Tree(4)])
>>> print(expr)
10
6
2
*
3
+
4
树抽象
树被用来表示形形色色的层次结构,比如机构的组织架构图、网页的结构,乃至 Python 代码本身。看待一棵树,有两种互补而相容的方式。递归式的描述与我们的 Tree 类相吻合,用的是树木术语:树有分支与叶子。
树也可以描述为节点(nodes)的集合,而节点就是那些 Tree 对象。每个节点有一个标签,并与其他节点存在关系。这一描述适用系谱学式的术语:一个节点的父节点(parent),是把它作为分支包含在内的那棵 Tree;一个节点的子节点(children),是其分支列表中那些 Tree 对象。一个节点的**祖先(ancestors)包括其父节点以及任何祖先的父节点;一个节点的后代(descendants)**包括其子节点以及任何后代的子节点。
两种描述方式都用**根(root)**一词指称包含整棵树的那个 Tree 对象,根标签就是这个对象的标签。
树的常见直观画法,是把每个标签写在一个节点里,再向每个子节点画一个箭头;根节点位于最上方。
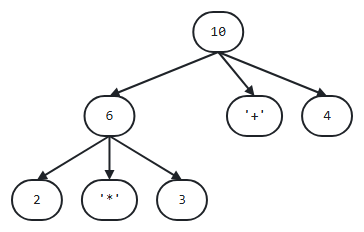
树递归函数
树递归函数可以用来构造树。例如,第 n 棵斐波那契树的根标签是第 n 个斐波那契数;当 n > 1 时,它有两个分支,也都是斐波那契树。斐波那契树体现了斐波那契数的树递归计算过程。
>>> def fib_tree(n: int) -> Tree[int]:
if n == 0 or n == 1:
return Tree(n)
else:
left, right = fib_tree(n-2), fib_tree(n-1)
fib_n = left.label + right.label
return Tree(fib_n, [left, right])
>>> print(fib_tree(5))
5
2
1
1
0
1
3
1
0
1
2
1
1
0
1
fib_tree(5) 这个对象可以递归地描述:一棵斐波那契树以某个斐波那契数为标签,以两棵斐波那契树为分支。其内容也可以依节点关系来描述:斐波那契树中每个节点的标签,都是其各子节点标签之和。
树递归函数也用来处理树。例如,sum_leaves 函数求一棵树各叶标签之和。
>>> def sum_leaves(t: Tree) -> int:
if is_leaf(t):
return t.label
else:
branch_sums = [sum_leaves(b) for b in t.branches]
return sum(branch_sums)
>>> sum_leaves(Tree(5, [Tree(100), Tree(1000, [Tree(3), Tree(20)])]))
123
>>> sum_leaves(fib_tree(5))
5
>>> sum_leaves(fib_tree(6))
8
注释
f'{p!r} ...'这种写法指示 f-string 采用Position的内建表示,而非format_pos所定义的那一种。这样一来,一旦把format_pos安装为「对Position调用str或print时生成输出」的函数,在format_pos内部生成错误信息时,就不会再次触发对format_pos的调用。↩
2.4 可变数据
我们已经看到,抽象对于应对大型系统的复杂性是何等重要。有效的编程还需要一些组织原则,来指引我们形成程序的整体设计。特别是,我们需要一些策略,帮助我们把大型系统组织得模块化(modular)——即自然而然地划分成若干连贯的部分,可以分别开发与维护。
打造模块化程序的一种强大技术,是引入可随时间改变状态的数据。这样一来,单个数据对象就可以表示某种独立于程序其余部分而演变的事物。一个不断变化的对象,其行为可能受其历史影响,正如世间的实体一样。为数据添加状态,是**面向对象编程(object-oriented programming)**这一范式的核心要素。
可变容器
数字这类基本内置值的实例都是不可变的(immutable):值本身在程序执行过程中无法改变。而列表与字典则是可变的(mutable)。
可变对象可以用来表示随时间改变的值。一个人今天与昨天是同一个人,尽管他长了年岁、理了头发,或以某种方式变了样。同样地,对象也可以因**变异操作(mutation operations)**而改变其性质。例如,列表的内容是可以改变的。多数改变都是通过调用列表对象上的方法完成的。
下面的例子讲述扑克牌的历史(经过大幅简化),借此引出许多列表修改操作。示例中的注释描述了每次方法调用的效果。
扑克牌大约在 9 世纪前后发明于中国。早期的一副牌有三种花色,对应着货币的面额。
>>> chinese = ['coin', 'string', 'myriad'] # 一个列表字面量
>>> suits = chinese # 两个名字指向同一个列表
随着纸牌传入欧洲(或许经由埃及),西班牙牌中只留下了「金币」这一花色(oro)。
>>> suits.pop() # 移除并返回最后一项
'myriad'
>>> suits.remove('string') # 移除第一个等于该实参的项
又添了三种花色(其名称与图样随时间演变),
>>> suits.append('cup') # 在末尾添加一项
>>> suits.extend(['sword', 'club']) # 把一个序列的所有项加到末尾
而意大利人把「剑」叫作 spade。
>>> suits[2] = 'spade' # 替换一项
于是得到了传统意大利牌的花色。
>>> suits
['coin', 'cup', 'spade', 'club']
如今在美国使用的法国牌,改掉了前两种花色:
>>> suits[0:2] = ['heart', 'diamond'] # 替换一个切片
>>> suits
['heart', 'diamond', 'spade', 'club']
列表还有用于插入、排序、反转的方法。所有这些变异操作都改变列表的值,而不会创建新的列表对象。
共享与标识。 因为我们一直在改动同一个列表,而非创建新列表,所以绑定到名字 chinese 的对象也变了——它与 suits 绑定的正是同一个列表对象!
>>> chinese # 这个名字与 "suits" 共同指向同一个不断变化的列表
['heart', 'diamond', 'spade', 'club']
这是一种新行为。从前,若某个名字未出现在某条语句中,它的值就不会受那条语句影响;而有了可变数据,施加于一个名字上的方法,可能同时影响另一个名字。
这个例子的环境图显示了:绑定到 chinese 的值,是如何被那些只涉及 suits 的语句所改变的。请单步走过下面例子的每一行,观察这些变化。
chinese = ['coin', 'string', 'myriad']
suits = chinese
suits.pop()
suits.remove('string')
suits.append('cup')
suits.extend(['sword', 'club'])
suits[2] = 'spade'
suits[0:2] = ['heart', 'diamond']
列表可以用 list 构造器函数复制。对其中一个列表的改动不会影响另一个——除非二者共享结构。
>>> nest = list(suits) # 把 "nest" 绑定到含相同各项的第二个列表
>>> nest[0] = suits # 创建一个嵌套列表
按这个环境,改变 suits 所引用的列表,将影响作为 nest 首项的那个嵌套列表,而不影响其他项。
>>> suits.insert(2, 'Joker') # 在下标 2 处插入一项,其余项后移
>>> nest
[['heart', 'diamond', 'Joker', 'spade', 'club'], 'diamond', 'spade', 'club']
同样地,撤销 nest 首项中的这处改动,也会改变 suits。
>>> nest[0].pop(2)
'Joker'
>>> suits
['heart', 'diamond', 'spade', 'club']
逐行走过这个例子,会看到嵌套列表的表示方式。
suits = ['heart', 'diamond', 'spade', 'club']
nest = list(suits)
nest[0] = suits
suits.insert(2, 'Joker')
joke = nest[0].pop(2)
两个列表的内容可能相同,而事实上却是不同的列表,因此我们需要一种手段来检验两个对象是否同一。Python 包含两个比较运算符 is 与 is not,用来检验两个表达式是否求值为同一个对象。若两个对象在当前值上相等,且对其中一个的任何改变总会反映在另一个上,则二者是同一的(identical)。同一性比相等性是更强的条件。
>>> suits is nest[0]
True
>>> suits is ['heart', 'diamond', 'spade', 'club']
False
>>> suits == ['heart', 'diamond', 'spade', 'club']
True
最后两个比较说明了 is 与 == 的区别:前者检验同一性,后者检验内容的相等性。
列表推导式。 列表推导式总是创建一个新列表。例如,unicodedata 模块记录了 Unicode 字母表中每个字符的正式名称;我们可以按名称查找对应的字符,包括扑克牌花色的字符。
>>> from unicodedata import lookup
>>> [lookup('WHITE ' + s.upper() + ' SUIT') for s in suits]
['♡', '♢', '♤', '♧']
所得的这个列表与 suits 不共享任何内容;求值这个列表推导式也不会修改 suits 列表。
关于文本表示的 Unicode 标准,可参阅 Dive into Python 3 的 Unicode 一节。
元组。 元组是不可变的序列。可以基于一个已有的元组创建新元组,但无法改变已有元组的长度,也无法改变其中各项的同一性。
虽然无法改变元组中包含哪些项,却可以改变元组内某个可变项的值。
nest = (10, 20, [30, 40])
nest[2].pop()
元组在多路赋值中被隐式使用:把两个值赋给两个名字,会创建一个二元组,然后把它解包。
字典。 字典是可变的。添加新的键值对,以及改变某个键已有的值,都可以通过赋值语句完成。
>>> numerals = {'I': 'one', 'V': 5, 'X': 10}
>>> numerals['I'] = 1
>>> numerals['L'] = 50
>>> numerals
{'I': 1, 'V': 5, 'X': 10, 'L': 50}
>>> numerals.pop('X')
10
>>> numerals
{'I': 1, 'V': 5, 'L': 50}
请注意,'I' 的值虽然变了,却仍保持原来的位置;而新键 'L' 被加到了末尾。字典保持插入顺序:打印字典时,键按其首次添加的次序出现;给已有的键赋新值并不改变其位置。
局部状态
列表与字典具有局部状态(local state):它们是不断变化的值,在程序执行的任一时刻都含有某种特定的内容。「状态」一词暗示着一个演变的过程,其中状态可能发生改变。
函数也可以有局部状态,存放在其父帧中。例如,我们来定义一个模拟从银行账户取款过程的函数。这个函数称为 withdraw,其实参是要取走的金额。若账户中余额足够,withdraw 便返回取款后剩余的金额;否则返回 'Insufficient funds'(余额不足)。例如,若账户起初有 100 美元,我们希望通过调用 withdraw 得到如下一系列返回值:
>>> withdraw(25)
75
>>> withdraw(25)
50
>>> withdraw(60)
'Insufficient funds'
>>> withdraw(15)
35
上面,表达式 withdraw(25) 求值两次,得到不同的值。因此,这个用户自定义函数是非纯的:调用它不只返回一个值,还带有副作用——以某种方式改变了函数自身,以至于下次以相同的实参调用,会返回不同的结果。这个副作用,源于 withdraw 改变了某个绑定在当前帧之外的名字上的列表的内容。
要让 withdraw 有意义,创建它时必须给出初始余额。函数 make_withdraw 是一个高阶函数,接受起始余额为实参,而 withdraw 是它的返回值。
>>> withdraw = make_withdraw(100)
下面 make_withdraw 的实现,用一个单元素的可变列表 state 来存储 withdraw 的状态。调用 make_withdraw 时,我们把 initial_balance 放进 state 列表;随后定义并返回一个局部函数 withdraw,它在被调用时更新并返回 state 的内容。
>>> def make_withdraw(initial_balance):
"""Return a withdraw function whose state starts at initial_balance and decreases with each call."""
state = [initial_balance]
def withdraw(amount):
if amount > state[0]:
return 'Insufficient funds'
state[0] = state[0] - amount
return state[0]
return withdraw
下面的环境图展示了多次调用 make_withdraw 所创建函数的效果。
def make_withdraw(initial_balance):
state = [initial_balance]
def withdraw(amount):
if amount > state[0]:
return 'Insufficient funds'
state[0] = state[0] - amount
return state[0]
return withdraw
wd = make_withdraw(20)
wd(5)
wd(3)
第一条 def 语句的效果一如往常:它创建一个新的用户自定义函数,并在全局帧中把名字 make_withdraw 绑定到该函数。随后对 make_withdraw 的调用,创建并返回一个局部定义的函数 withdraw,它在全局帧中被绑定到名字 wd。在 make_withdraw 帧中,名字 state 绑定到一个列表,其中盛着起始余额 20。关键在于:在本例余下的过程中,名字 state 只有这唯一一处绑定。
接着,我们求值一个表达式,以金额 5 调用这个绑定于名字 wd 的函数。withdraw 的函数体,在一个新的环境中执行——该环境扩展了定义 withdraw 时的那个环境。
withdraw 函数并没有使用 initial_balance,而是使用并更新 state[0]。一条以 state[0] 位于 = 左边的赋值语句,并不绑定名字 state;它是在当前环境中查找 state,在 make_withdraw 帧中找到它,然后改变那个列表的内容。更新列表中的某一项是允许的,即便该列表的名字并不出现在局部帧中,而出现在当前环境的某个非局部帧或全局帧中。
由于改变了 state 的内容,我们也就改变了 withdraw 函数。下一次它被调用时,state[0] 求值为 15 而非 20。于是,当我们第二次调用 withdraw 时,看到它的返回值是 12 而非 17——第一次调用对 state 的改动,影响了第二次调用的结果。
第二次调用 withdraw 照常创建了第二个局部帧。然而,两个 withdraw 帧有着相同的父环境——它们都扩展了 make_withdraw 的环境,而那里含 state 的绑定。因此,它们共享这个列表的内容。调用 withdraw 的副作用,改变了未来调用 withdraw 时所要扩展的环境。在父环境里使用可变值,使得 withdraw 得以改变自己未来的行为。
Python 的一个特殊限制。 Python 在名字查找上有一条不寻常的限制:在函数体内部,同一个名字的所有出现都必须指称同一个帧。因此,Python 不能先在一个非局部帧中取得某名字的值,再在局部帧中绑定同一个名字——因为同一个名字就会在同一个函数中的两个不同帧里被访问。这条限制让 Python 得以在执行函数体之前,预先算好每个名字位于哪个帧。一旦违反这条限制,就会得到一条令人困惑的错误信息。为作演示,下面把 make_withdraw 的例子重写一遍,但不使用 state 列表。
def make_withdraw(initial_balance):
balance = initial_balance
def withdraw(amount):
if amount > balance:
return 'Insufficient funds'
balance = balance - amount
return balance
return withdraw
wd = make_withdraw(20)
wd(5)
这里出现的 UnboundLocalError,是因为 balance 在第 6 行被局部赋值,于是 Python 假定所有对 balance 的引用也必须出现在局部帧中。这个错误甚至在第 6 行执行之前就已发生,这意味着 Python 在执行第 4 行之前,就已经以某种方式考量过第 6 行。把余额存进 state 列表便可避开这个错误,因为 withdraw 从不改变 state 所指的对象,只改变该对象的内容。
变异的好处
编写一个会更新自身状态的函数,是迈向「把复杂程序看作一组独立自治的对象」的第一步——这些对象彼此交互,却各自管理自己的内部状态。
列表变异赋予我们一种能力:维持某种局部于函数的、在一次又一次调用中不断演变的状态。与某个特定 withdraw 函数相关联的状态,为该函数的所有调用所共享;然而,这个状态对程序其余部分却是不可访问的。只有 wd 与 make_withdraw 的帧相关联,而函数正是在那个帧中定义的。若再次调用 make_withdraw,它会创建一个独立的帧,其中有独立的 state 绑定。
我们可以扩展这个例子来说明这一点。第二次调用 make_withdraw,返回第二个 withdraw 函数,它有着不同的父环境。我们在全局帧中把这第二个函数绑定到名字 wd2。
def make_withdraw(initial_balance):
state = [initial_balance]
def withdraw(amount):
if amount > state[0]:
return 'Insufficient funds'
state[0] = state[0] - amount
return state[0]
return withdraw
wd = make_withdraw(20)
wd2 = make_withdraw(7)
wd2(6)
wd(8)
现在,我们看到事实上在不同的两个帧里有两处名字 state 的绑定,而每个 withdraw 函数都有不同的父环境。名字 wd 绑定到一个函数,其状态列表含 20;而 wd2 绑定到另一个函数,其状态列表含 7。
调用 wd2 会改变其父帧中 state 列表的内容,却不影响绑定到名字 wd 的函数。结果,调用 wd 所用的状态列表仍含 20。
这样一来,每个 withdraw 实例都维护自己的状态,而那份状态对程序中的任何其他函数都不可访问。从更高的层面看,我们创造了一个银行账户的抽象:它管理自己的内部事务,其行为却与世界上的账户相仿——随着自身取款请求的历史而改变。
变异的代价
我们的环境计算模型可以干净利落地延展,用来解释变异的效果。然而,变异为我们思考名字与值的方式带来了若干重要的微妙之处。
从前,我们的值不会改变,变的只是名字与绑定。当两个名字 a 与 b 都绑定到值 4 时,它们绑定的是同一个 4 还是不同的 4,都无关紧要——就我们所能分辨的而言,只有一个永不改变的 4 对象。
然而,带状态的函数并非如此。当两个名字 wd 与 wd2 都绑定到一个 withdraw 函数时,它们绑定的是同一个函数还是该函数的不同实例,就大有关系了。考虑下面这个例子,它与我们刚才分析的那个形成对照。在此,调用 wd2 所指名的函数,确实改变了 wd 所指名函数的状态,因为两个名字指向同一个函数。
def make_withdraw(initial_balance):
state = [initial_balance]
def withdraw(amount):
if amount > state[0]:
return 'Insufficient funds'
state[0] = state[0] - amount
return state[0]
return withdraw
wd = make_withdraw(12)
wd2 = wd
wd2(1)
wd(1)
在世间,两个名字共同指称同一个值,并不罕见;在我们的程序中亦然。但是,既然值会随时间改变,我们就必须格外小心,弄清一处改变对其他可能指称这些值的名字有何影响。
同一与变化。 这些微妙之处之所以出现,是因为引入了会改变父帧所引用值的非纯函数,我们便改变了表达式的性质。只含纯函数调用的表达式是引用透明的(referentially transparent):若把它的某个子表达式替换为该子表达式的值,它的值不会改变。
变异操作违反了引用透明的条件,因为它们做的不仅仅是返回一个值,它们还改变环境。一旦引入变异,我们便遭遇一个棘手的认识论问题:两个值「相同」究竟意味着什么。在我们的环境计算模型中,两个分别定义的函数并不相同,因为对其中一个的改动未必反映在另一个上。
总的来说,只要我们从不变异数据对象,就可以把一个复合数据对象视为其各部分的精确总和。例如,一个地理位置由它的纬度与经度所确定。然而,在有变化的情况下,这一观点便不再成立——此时复合数据对象具有一种「身份(identity)」,它与构成它的那些部分有所不同。即便我们取款改变了余额,一个银行账户仍然是「同一个」银行账户;反过来说,我们也可以有两个账户,碰巧余额相同,却是不同的对象。
尽管带来了种种复杂之处,变异仍是打造模块化程序的强大工具。程序的不同部分——对应着不同的环境帧——可以在程序执行过程中各自独立地演变。
2.5 面向对象编程
**面向对象编程(Object-oriented programming,OOP)**是一种组织程序的方法,它把本章引入的许多观念融于一炉:对象有决定其行为的类型(2.1 节);对象可以包含其他对象(2.2 节);class 语句可以引入把数据与行为捆绑在一起的新类型(2.3 节);对象具有可变的局部状态(2.4 节)。OOP 还剩下两个组成部分:定制对象的行为,以及在相关类型之间共享行为。这些观念合在一起,使程序得以围绕「创建与操作对象和类型」来组织。Python 提供了方便的语法来推广这些技术,而其中许多语法为其他面向对象编程语言所共有。
对象语法带来的便利不止于此。它开启了一种新的程序设计隐喻:若干独立组件在计算机内部相互作用。对象把局部状态与行为捆绑在一起,从而把「计算机硬件或语言解释器如何存储、操作数据」这类细节抽象掉。对象彼此通信,而有益的结果正是其交互的产物。对象还可以在同类的其他对象之间共享行为,并从相关类型继承行为。
对象与类
**类(class)**是类型为该类的一切对象的模板。每个对象都是某个类的实例。用户自定义的类可以定制其实例行为的诸多细节。类的 @dataclass 装饰器为对象的行为提供了合理的默认实现,但从现在起,我们将转而自行定义类的每一个方面。类定义规定了该类对象之间共享的属性与方法。我们可以从重温银行账户的例子入手,来学习类定义的细节。
在引入局部状态时我们看到,银行账户很自然地可以建模为带余额的可变值。一个银行账户对象应当有一个 withdraw 方法,它更新账户余额,并在余额允许时返回所请求的金额。再补全这份抽象:银行账户还应能返回当前余额、返回账户持有人的姓名,以及有一个存款金额。
Account 类让我们得以创建多个银行账户实例。创建新对象实例这一动作,称为**实例化(instantiating)**该类。Python 中实例化类的语法,与调用函数的语法完全相同。在本例中,我们以账户持有人的姓名 'Kirk' 为实参调用 Account。
>>> a = Account('Kirk')
对象的属性(attribute)是与该对象关联的名字-值对,可通过点记法访问。特定于某个对象(而非某个类的所有对象)的属性,称为实例属性(instance attributes)。每个 Account 都有自己的余额与持有人姓名,二者都是实例属性的例子。在更广泛的编程界,实例属性也叫字段(fields)、成员变量(member variables)或实例变量(instance variables)。
>>> a.holder
'Kirk'
>>> a.balance
0
作用于对象、或执行对象特有计算的函数,称为方法(methods)。方法的返回值与副作用,可以依赖并改变对象的其他属性。例如,deposit 就是 Account 对象 a 的一个方法:它接受一个实参——要存入的金额,改变对象的 balance 属性,并返回所得的余额。
>>> a.deposit(15)
15
我们说,方法是在某个特定对象上**被调用(invoked)**的。调用 withdraw 方法的结果是:要么取款获准、金额被扣除;要么请求被拒、方法返回一条错误信息。
>>> a.withdraw(10) # withdraw 方法返回取款后的余额
5
>>> a.balance # balance 属性已经改变
5
>>> a.withdraw(10)
'Insufficient funds'
如上所示,方法的行为可以依赖对象不断变化的属性。两次以相同实参调用 withdraw,返回的结果却不同。
定义类
用户自定义的类由 class 语句创建:它先定义类名,然后包含一组语句,用来定义该类的属性与方法:
class <name>:
<suite>
class 语句执行时,会创建一个新类,并在当前环境的第一个帧中把它绑定到 <name>,随后执行那组语句。凡是通过 def 或赋值语句在那组语句中绑定的名字,都会创建或修改该类的属性。
类通常是围绕操作实例属性来组织的——实例属性就是与类的每个实例相关联的名字-值对。类通过定义一个初始化新对象的方法,来规定其对象的实例属性。例如,初始化 Account 类对象的工作之一,就是把它的起始余额赋为 0。
class 语句的那组语句中包含若干 def 语句,为该类的对象定义新方法。初始化对象的方法在 Python 中有一个特殊的名字 __init__(「init」两侧各有两个下划线),称为该类的构造器(constructor)。
>>> class Account:
def __init__(self, account_holder):
self.balance = 0
self.holder = account_holder
Account 的 __init__ 方法有两个形式参数。第一个 self,绑定到新创建的 Account 对象;第二个 account_holder,绑定到实例化时调用该类所传入的实参。
构造器把实例属性名 balance 绑定为 0,也把属性名 holder 绑定到名为 account_holder 的实参。形式参数 account_holder 是 __init__ 方法中的局部名字;而最后一条赋值语句所绑定的名字 holder 则会留存下来,因为它通过点记法被存储为 self 的属性。
定义好 Account 类之后,我们便可以实例化它。
>>> a = Account('Kirk')
这次对 Account 类的「调用」,创建了一个属于 Account 实例的新对象,然后以两个实参调用构造器函数 __init__:新创建的对象,以及字符串 'Kirk'。按照惯例,我们把构造器的第一个参数取名为 self,因为它总是绑定到正在被实例化的那个对象。这一惯例在几乎所有 Python 代码中都被采用。
现在,我们可以用点记法访问对象的 balance 与 holder 了。
>>> a.balance
0
>>> a.holder
'Kirk'
与用 @dataclass 装饰的类不同,标准的 class 语句不含固定的实例属性清单;为新构造的对象添加实例属性,是 __init__ 的职责。同一个类的不同实例可以有不同的实例属性,尽管最常见的情形是 __init__ 为每个实例添加相同的属性。
标识(Identity)。 每个新的账户实例都有自己的 balance 属性,其值独立于同类的其他对象。
>>> b = Account('Spock')
>>> b.balance = 200
>>> [acc.balance for acc in (a, b)]
[0, 200]
为了确保这种独立性,用户自定义类的每个实例对象都有独一无二的标识(identity)。对象标识用 is 与 is not 运算符比较。
>>> a is a
True
>>> a is not b
True
用赋值把对象绑定到新名字,并不会创建新对象;它只是为当前环境中已有的对象又添了一个名字。
>>> c = a
>>> c is a
True
要创建另一个 Account 实例,必须调用 Account。
方法。 对象的方法同样由 class 语句那组语句中的 def 语句定义。下面 deposit 与 withdraw 都定义为 Account 类对象上的方法。
>>> class Account:
def __init__(self, account_holder):
self.balance = 0
self.holder = account_holder
def deposit(self, amount):
self.balance = self.balance + amount
return self.balance
def withdraw(self, amount):
if amount > self.balance:
return 'Insufficient funds'
self.balance = self.balance - amount
return self.balance
方法的定义在声明方式上与标准函数定义并无不同,但它们出现在 class 语句之中,这就意味着它们成了该类的方法。此后,便可用点记法在类的实例上调用它们。
每个方法定义同样包含一个特殊的第一参数 self,它绑定到调用该方法时所作用的对象。例如,假设 deposit 是在某个 Account 对象上调用、并传入一个 int 实参(存款金额):对象本身绑定到 self,实参则绑定到 amount。所有被调用的方法都通过 self 参数访问对象,因而都能访问并操作对象的状态。
要调用这些方法,我们再次使用点记法,如下所示。
>>> spock_account = Account('Spock')
>>> spock_account.deposit(100)
100
>>> spock_account.withdraw(90)
10
>>> spock_account.withdraw(90)
'Insufficient funds'
>>> spock_account.holder
'Spock'
当通过点记法调用方法时,对象本身(此处绑定于 spock_account)扮演着双重角色。其一,它决定名字 withdraw 所指为何——withdraw 并不是环境中的名字,而是 Account 类局部的名字。其二,在调用 withdraw 方法时,它绑定到第一个参数 self。
消息传递与点表达式
定义于类中的方法与通常在构造器中初始化的实例属性,是面向对象编程的基本元素。一个有用的比喻是:调用方法就是向对象发送消息,而返回值就是它的回应。类规定了其实例能接收哪些消息(即哪些方法可用)。消息传递这一比喻的核心观念是:对象应当具备行为——对与其所代表的抽象类型相关的消息作出回应。
点表达式。 代码片段 spock_account.deposit 称为点表达式(dot expression)。点表达式由一个表达式、一个点和一个名字构成:
<expression> . <name>
<expression> 可以是任何合法的 Python 表达式,但 <name> 必须是简单的名字(不能是会求值为名字的表达式)。点表达式的值,是 <expression> 之值那个对象上、名字为 <name> 的属性的值。
内置函数 getattr 同样按名字返回对象的某个属性,它是点记法的函数等价物。借助 getattr,我们可以用字符串来查找属性。
>>> getattr(spock_account, 'balance')
10
我们还可以用 hasattr 检验对象是否具有某个具名属性。
>>> hasattr(spock_account, 'deposit')
True
对象的属性,包括其全部实例属性,加上其类中定义的全部属性(含方法)。方法属于类的属性,只是需要特殊处理。
方法与函数。 当方法在对象上被调用时,该对象会隐式地作为第一个实参传给方法。也就是说,点号左侧 <expression> 之值那个对象,会自动作为第一个实参传给点表达式右侧所指名的方法;结果,对象绑定到参数 self。
为了实现自动的 self 绑定,Python 区分函数(我们自本书开篇以来一直在创建的东西)与绑定方法(bound methods)——后者把一个函数与「该方法将作用于其上的对象」耦合在一起。绑定方法值已经与其第一个实参(即调用时所在的那个实例)相关联,方法被调用时,这个实例将被命名为 self。
在交互式解释器中对点表达式所返回的值调用 type,便能看出差别。作为类的属性,方法只是一个函数;而作为实例的属性,它则是绑定方法:
>>> type(Account.deposit)
<class 'function'>
>>> type(spock_account.deposit)
<class 'method'>
这两个结果唯一的差别在于:前者是标准的双参数函数,参数为 self 与 amount;后者是单参数方法,其中的名字 self 在方法被调用时会自动绑定到名为 spock_account 的对象,而参数 amount 则绑定到传给方法的实参。这两个值——无论函数值还是绑定方法值——都关联着同一个 deposit 函数体。
我们可以用两种方式调用 deposit:作为函数,或作为绑定方法。前者必须显式地为 self 参数提供实参;后者则会自动绑定 self。
>>> Account.deposit(spock_account, 1001) # deposit 函数接受 2 个实参
1011
>>> spock_account.deposit(1000) # deposit 方法接受 1 个实参
2011
函数 getattr 的行为与点记法如出一辙:若它的第一个实参是对象、而名字是类中定义的方法,则 getattr 返回一个绑定方法值;反之,若第一个实参是类,则 getattr 直接返回该属性的值,即一个普通函数。
命名惯例。 类名按惯例采用 CapWords 约定书写(也叫 CamelCase,因为名字中间的大写字母看上去像驼峰)。方法名则遵循标准的函数命名惯例:小写单词、下划线分隔。
有时,某些实例属性与方法关乎对象的维护与一致性,而我们并不希望对象的使用者看到或使用它们。它们不属于类所定义的抽象,而属于实现。Python 的惯例是:若属性名以下划线开头,则该属性只应在该类自身的方法内部访问,而不应被类的使用者访问。
属性访问。 在某些编程语言中,直接访问或改变属性值(而非调用方法)要么不受鼓励,要么被禁止。Python 也支持这种风格——详见 Python 教程中关于私有变量的一节,那里的实例属性不直接访问,而是经由方法访问。不过,现实中的 Python 程序常常直接访问并更新属性。
类属性
有些属性值为某个类的所有实例所共享。这样的属性关联于类本身,而非类的任何个别实例。例如,假设银行按固定利率为账户余额支付利息:利率可能会变,但它是所有账户共享的单一值。
类属性由 class 语句那组语句中、位于任何方法定义之外的赋值语句创建。在更广泛的编程界,类属性也叫类变量(class variables)或静态字段(static fields)。下面的 class 语句为 Account 创建了一个名为 interest 的类属性。
>>> class Account:
interest = 0.02 # 一个类属性
def __init__(self, account_holder):
self.balance = 0
self.holder = account_holder
# 其他方法将在此处定义
这个属性仍然可以从该类的任何实例访问。
>>> spock_account = Account('Spock')
>>> kirk_account = Account('Kirk')
>>> spock_account.interest
0.02
>>> kirk_account.interest
0.02
然而,对类属性的一条赋值语句,会改变该类所有实例上该属性的值。
>>> Account.interest = 0.04
>>> spock_account.interest
0.04
>>> kirk_account.interest
0.04
方法也是类属性——它们是为该类所有实例共享的函数。不过,「类属性」一词最常用于描述非函数值的属性,而取值为函数的类属性则称为方法。
属性名的解析。 现在需要规定名字如何解析到具体的属性,因为我们很容易遇到一个类属性与一个实例属性同名的情形。
如前所述,点表达式由一个表达式、一个点和一个名字构成:
<expression> . <name>
要求值点表达式:
- 求值点号左侧的
<expression>,得到点表达式所作用的对象; - 用
<name>去匹配该对象的实例属性;若存在该名字的属性,就返回其值; - 若
<name>不在实例属性之中,就在类中查找<name>,得到某个类属性的值; - 返回该值;除非它是函数,那样的话就返回一个绑定方法。
在这一求值流程中,实例属性先于类属性被找到,正如环境中局部名字优先于全局名字。定义在类中的方法,会在这一流程的第四步与点表达式的对象结合,构成绑定方法。
属性赋值。 凡左侧含点表达式的赋值语句,都影响该点表达式所作用对象的属性:若对象是实例,赋值便设置一个实例属性;若对象是类,赋值便设置一个类属性。作为这条规则的结果,对对象属性的赋值不会影响其类的属性。下面的例子说明了这一区别。
若为某个账户实例的具名属性 interest 赋值,我们就创建了一个实例属性,它与既有的类属性同名。
>>> kirk_account.interest = 0.08
此后,点表达式将返回这个属性值。
>>> kirk_account.interest
0.08
然而,类属性 interest 仍保留其原值,对其他账户一律返回该值。
>>> spock_account.interest
0.04
对类属性 interest 的改动会影响 spock_account,但 kirk_account 的实例属性不受影响。
>>> Account.interest = 0.05 # 改变类属性
>>> spock_account.interest # 会改变那些没有同名实例属性的实例
0.05
>>> kirk_account.interest # 但既有的实例属性不受影响
0.08
继承
在面向对象编程的范式下工作时,我们常常发现不同的类型彼此相关,理应共享行为。尤其是,相似的类可能在专门化的程度上有所差别:两个类或许有相似的属性,但其中一个代表着另一个的特例。
例如,下面是一种与标准账户略有不同的支票账户。支票账户每次取款多收 1 美元,利率也更低。这里演示了我们期望的行为。
>>> ch = CheckingAccount('Spock')
>>> ch.interest # 支票账户利率更低
0.01
>>> ch.deposit(20) # 存款行为相同
20
>>> ch.withdraw(5) # 取款会额外扣除费用
14
CheckingAccount 是 Account 的一种专门化。用 OOP 的术语说,通用账户将充当 CheckingAccount 的基类(base class),而 CheckingAccount 将是 Account 的子类(subclass)。(基类也叫父类(parent class)或超类(superclass),子类也叫子级类(child class)。)
子类继承其基类的类属性,但可以**覆盖(override)**某些属性,包括某些方法。有了继承,我们只需指明子类与基类之间的差异;子类中未加指明的一切,都自动被假定为与基类中的表现相同。
继承除了是一项有用的组织特性之外,在我们的对象隐喻中也有其角色。继承意在表示类与类之间的 **is-a(是……)**关系,与 **has-a(有……)**关系相对。支票账户是(is-a)一种特定类型的账户,因此让 CheckingAccount 继承 Account,是继承的恰当运用。另一方面,一家银行有(has-a)一份它所管理的银行账户列表,所以二者谁都不应继承对方;相反,账户对象列表很自然地应表达为银行对象的一个实例属性。
使用继承
首先,给出 Account 类的完整实现,含类及其方法的文档字符串。
>>> class Account:
"""A bank account that has a non-negative balance."""
interest = 0.02
def __init__(self, account_holder):
self.balance = 0
self.holder = account_holder
def deposit(self, amount):
"""Increase the account balance by amount and return the new balance."""
self.balance = self.balance + amount
return self.balance
def withdraw(self, amount):
"""Decrease the account balance by amount and return the new balance."""
if amount > self.balance:
return 'Insufficient funds'
self.balance = self.balance - amount
return self.balance
下面是 CheckingAccount 的完整实现。我们把一个求值为基类的表达式放在类名之后的圆括号里,以此指明继承。
>>> class CheckingAccount(Account):
"""A bank account that charges for withdrawals."""
withdraw_charge = 1
interest = 0.01
def withdraw(self, amount):
return super().withdraw(amount + self.withdraw_charge)
这里,我们引入了一个 CheckingAccount 类特有的类属性 withdraw_charge,为 interest 属性赋了更低的值,还定义了一个新的 withdraw 方法来覆盖 Account 类中定义的行为。由于类的那组语句中没有更多语句,其余一切行为都继承自基类 Account。
>>> checking = CheckingAccount('Sam')
>>> checking.deposit(10)
10
>>> checking.withdraw(5)
4
>>> checking.interest
0.01
表达式 checking.deposit 求值为一个用于存款的绑定方法,它定义在 Account 类中。当 Python 解析点表达式中某个并非实例属性的名字时,它会在类中查找该名字。事实上,在类中「查找」名字这一动作,会试图在原始对象所属类的继承链上的每一个基类中寻找该名字。我们可以递归地定义这一流程。要在类中查找一个名字:
- 若该类中有以此为名的属性,则返回该属性值;
- 否则,若有基类,就在基类中查找该名字。
就 deposit 而言,Python 会先在实例上找这个名字,然后在 CheckingAccount 类中找,最后在 Account 类中找到 deposit 的定义。按照我们关于点表达式的求值规则,由于 deposit 是在 checking 实例所属的类中查找到的函数,点表达式求值为一个绑定方法值。该方法以实参 10 被调用,即调用 deposit 方法,self 绑定到 checking 对象、amount 绑定为 10。
对象的类自始至终保持不变。尽管 deposit 方法是在 Account 类中找到的,调用 deposit 时 self 却绑定到 CheckingAccount 的实例,而非 Account 的实例。
调用祖先。 被覆盖的属性仍可通过 super() 访问,它返回 self 的一个变体,在祖先类中查找类属性,而跳过定义该方法的那个类。例如,我们通过 super().withdraw 实现了 CheckingAccount 的 withdraw 方法,它求值为 Account.withdraw 函数的绑定方法。由于 CheckingAccount 是 Account 的子类,在 CheckingAccount 的方法内调用 super().withdraw(x),等价于调用 Account.withdraw(self, x)。super() 写法如今是 Python 中更受青睐的语法,因为它不必重复基类名,而且在类名或继承关系变动时往往无需更新。
可扩展性。 我们用的是 self.withdraw_charge,而非等价的 CheckingAccount.withdraw_charge。前者优于后者之处在于:继承自 CheckingAccount 的类可能会覆盖取款手续费。若真如此,我们希望 withdraw 的实现能找到那个新值,而不是旧值。总的来说,最好通过 self 来查找类属性,这样日后子类便能覆盖该属性的值,而不必连使用它的那些方法一并覆盖。
接口。 在面向对象程序中,不同类型的对象共享相同的属性名,是极其常见的。**对象接口(object interface)**是一组属性以及对这些属性的条件规定。例如,所有账户都必须有 deposit 与 withdraw 方法(接受数值实参),以及一个 balance 属性。Account 与 CheckingAccount 两个类都实现了这个接口。继承尤其以这种方式促成名字共享。在某些编程语言(如 Java)中,实现接口必须显式声明;而在另一些语言(如 Python、Ruby 与 Go)中,任何具有相应名字的对象都算实现了某个接口。
程序中使用对象(而非实现对象)的那些部分,若不对对象类型作假设、而只对其属性名作假设,那么面对未来的变化将最为稳健。也就是说,它们用的是对象抽象,而不对实现作任何假定。
例如,假设我们经营一项抽奖,想往一个列表中的每个账户存入 5 美元。下面这个实现不对这些账户的类型作任何假设,因此与任何具有 deposit 方法的对象都能配合得天衣无缝:
>>> def deposit_all(winners, amount=5):
for account in winners:
account.deposit(amount)
上面的 deposit_all 只假定每个账户满足账户对象的抽象,因此它与任何同样实现了这一接口的其他账户类都能配合。若假定某一种特定的账户类,那就破坏了账户抽象的这一抽象屏障。例如,下面这个实现就未必能用于新种类的账户:
>>> def deposit_all(winners, amount=5):
for account in winners:
Account.deposit(account, amount)
多继承
Python 支持子类从多个基类继承属性,这一语言特性称为多继承(multiple inheritance)。
假设我们有一个 SavingsAccount,它继承 Account,但每次存款都向客户收取一小笔费用。
>>> class SavingsAccount(Account):
deposit_charge = 2
def deposit(self, amount):
return super().deposit(amount - self.deposit_charge)
于是,一位精明的经理设想出 AsSeenOnTVAccount(「电视同款」账户):集 CheckingAccount 与 SavingsAccount 两家之长于一身——取款收费、存款收费,利率还低。它既是支票账户又是储蓄账户,合二为一!「我们把它做出来,」经理盘算着,「总有人会注册,把这些费用统统交上。我们甚至送他一美元。」
>>> class AsSeenOnTVAccount(CheckingAccount, SavingsAccount):
def __init__(self, account_holder):
self.holder = account_holder
self.balance = 1 # 免费的一美元!
事实上,这个实现已经完整了。取款与存款都会产生费用——分别使用 CheckingAccount 与 SavingsAccount 中的函数定义。
>>> such_a_deal = AsSeenOnTVAccount("John")
>>> such_a_deal.balance
1
>>> such_a_deal.deposit(20) # 来自 SavingsAccount.deposit 的 2 美元费用
19
>>> such_a_deal.withdraw(5) # 来自 CheckingAccount.withdraw 的 1 美元费用
13
不引起歧义的引用得到了正确解析:
>>> such_a_deal.deposit_charge
2
>>> such_a_deal.withdraw_charge
1
但若引用有歧义,比如对同定义于 Account 与 CheckingAccount 中的 withdraw 方法的引用,又当如何?下图描绘了 AsSeenOnTVAccount 类的继承图,每个箭头都从子类指向基类。
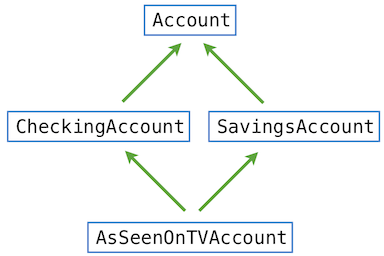
对于这种简单的「菱形」结构,Python 解析名字的顺序是先左后右,再向上。在这个例子里,Python 依次在下列类中查找某个属性名,直到找到一个以此为名的属性为止:
AsSeenOnTVAccount, CheckingAccount, SavingsAccount, Account, object
继承顺序问题并没有唯一正确的解法,因为在某些情况下,我们可能更愿意让某些继承类优先于其他类。然而,任何支持多继承的编程语言,都必须以一致的方式选定某种顺序,好让语言的使用者能够预知程序的行为。
延伸阅读。 Python 用一个称为 C3 方法解析顺序(C3 Method Resolution Ordering) 的递归算法来解析这个名字。任何类的方法解析顺序,都可以用所有类上的 mro 方法查询。
>>> [c.__name__ for c in AsSeenOnTVAccount.mro()]
['AsSeenOnTVAccount', 'CheckingAccount', 'SavingsAccount', 'Account', 'object']
寻找方法解析顺序的精确算法不是本书的话题,但 Python 的主要作者曾撰文描述,并引用了原始论文。
对象的角色
Python 的对象系统,旨在让数据抽象与消息传递既方便又灵活。类、方法、继承与点表达式的专门语法,都让我们得以在程序中采纳对象隐喻,从而增强我们组织大型程序的能力。
具体而言,我们希望对象系统能促进程序中不同方面之间的关注点分离(separation of concerns)。程序中的每个对象,都封装并管理着程序状态的某一部分;每条 class 语句,都定义了实现程序整体逻辑中某一部分的那些函数。
面向对象编程尤其适合那些对「彼此分离却又相互作用的部件」进行建模的程序。例如,在社交网络中,不同的用户相互交流;在游戏中,不同的角色相互较量;在物理仿真中,不同的形状相互作用。在表示这类系统时,程序中的对象常常自然而然地映射到被建模系统中的对象上,而类则表征它们的类型与关系。
另一方面,类未必是实现某些抽象的最佳机制。函数抽象为表示输入与输出之间的关系提供了更自然的隐喻。我们不该觉得非要把程序中的每一段逻辑都塞进某个类里,尤其是在「为操作数据而定义独立的函数」更为自然的时候。函数同样能实现关注点分离。
像 Python 这样的多范式语言(multi-paradigm languages),让程序员得以把组织范式与恰当的问题相配。学会判断何时该引入一个新类、而非一个新函数,以使程序更简单、更模块化,这是软件工程中一项重要的设计本领,值得认真对待。
2.6 实现类与对象
在面向对象编程的范式下工作时,我们用对象隐喻来指引程序的组织。关于如何表示与操作数据的大多数逻辑,都表达在类声明之中。本节我们将看到:类与对象本身,仅用函数与字典就能表示出来。以这种方式实现一个对象系统,用意在于说明:运用对象隐喻并不需要一门特殊的编程语言。即便在那些没有内置对象系统的编程语言中,程序同样可以是面向对象的。
为了实现对象,我们将放弃点记法(它确实需要语言的内建支持),转而创建行为与内置类和实例颇为相像的字典。仿照 Python 的内置对象系统,我们将在实例、类与基类之间发送消息。在我们的实现中,消息是字符串而非属性名,而属性本身则存储在字典里。
我们的实现并不打算逐一遵循 Python 类型系统的每个细节,而是要捕捉支撑面向对象编程的核心功能。
分派字典
我们的实现将围绕**分派字典(dispatch dictionaries)**来设计——这是一种键为字符串、值为函数的字典,用来回应消息。下面是一个分派字典的例子。它回应 "add" 与 "subtract" 两条消息,操作的是一个单元素列表中的计数。
>>> def counter():
state = [0]
def add(k):
state[0] += k
return state[0]
def subtract(k):
state[0] -= k
return state[0]
return {"add": add, "subtract": subtract}
>>> first = counter()
>>> first["add"](3)
3
>>> first["add"](3)
6
>>> first["subtract"](2)
4
>>> second = counter()
>>> second["add"](5)
5
>>> second["add"](5)
10
>>> first["subtract"](2)
2
>>> second["subtract"](3)
7
实例
我们从实例说起。实例具有具名属性,比如账户的余额,可以设置与获取。我们用一个分派字典来实现实例,它回应「获取」与「设置」属性值的消息。属性本身存储在一个名为 attributes 的局部字典中。
开始实现时,我们假定已有一个类实现,可以用来查找不属于该实例的任何名字。我们把一个类作为参数 cls 传入 make_instance。
>>> def make_instance(cls):
"""Return a new object instance, which is a dispatch dictionary."""
def get_value(name):
if name in attributes:
return attributes[name]
else:
value = cls['get'](name)
return bind_method(value, instance)
def set_value(name, value):
attributes[name] = value
attributes = {}
instance = {'get': get_value, 'set': set_value}
return instance
实例是一个回应 get 与 set 消息的分派字典。set 消息对应 Python 对象系统中的属性赋值:所有被赋值的属性都直接存入对象本地的属性字典。在 get 中,若 name 不在本地属性字典中,就到类中查找;若 cls 返回的值是函数,则必须把它绑定到该实例。
绑定方法值。 make_instance 中的 get_value 函数用 get 在类中找到具名属性,然后调用 bind_method。方法绑定只施加于函数值,它通过把实例作为第一个参数插入,从函数值创建一个绑定方法值:
>>> def bind_method(value, instance):
"""Return a bound method if value is callable, or value otherwise."""
if callable(value):
def method(*args):
return value(instance, *args)
return method
else:
return value
def method(*args) 这种语法让 method 可以接受任意多个实参,并把名字 args 绑定到含所有传入实参的元组。同样地,value(instance, *args) 这种语法以多个实参调用 value:instance 作为第一个实参,args 中的每一项作为额外的实参。内置函数 callable 返回其实参是否可被调用。
当方法被调用时,按照这个定义,第一个参数 self 将绑定到 instance 的值。
类
在 Python 的对象系统中,以及我们在此实现的系统中,类同样是一个对象。为简单起见,我们说类本身没有类。(在 Python 中,类确实有类;几乎所有类共享同一个类,称为 type。)类可以回应 get 与 set 消息,以及 new 消息:
>>> def make_class(attributes, base_class=None):
"""Return a new class, which is a dispatch dictionary."""
def get_value(name):
if name in attributes:
return attributes[name]
elif base_class is not None:
return base_class['get'](name)
def set_value(name, value):
attributes[name] = value
def new(*args):
return init_instance(cls, *args)
cls = {'get': get_value, 'set': set_value, 'new': new}
return cls
与实例不同,当属性找不到时,类的 get 函数并不查询自己的类,而是查询其 base_class。类不需要方法绑定。
初始化。 make_class 中的 new 函数调用 init_instance:后者先创建一个新实例,然后调用名为 __init__ 的方法。
>>> def init_instance(cls, *args):
"""Return a new object with type cls, initialized with args."""
instance = make_instance(cls)
init = cls['get']('__init__')
if init:
init(instance, *args)
return instance
这最后一个函数补全了我们的对象系统。现在我们有实例:设置属性时存在本地,获取属性时找不到便回退到类;实例在类中查找到名字后,会把自身绑定到函数值上,创建方法。最后,类能够创建新实例,并在实例创建之后立即施加其 __init__ 构造器函数。
在这个对象系统中,用户唯一应当调用的函数就是 make_class;其余一切功能都通过消息传递来启用。同样地,Python 的对象系统经由 class 语句调用,而其余一切功能则通过点表达式以及对类的调用启用。
使用所实现的对象
现在回到上一节的银行账户例子。用我们实现的对象系统,我们将创建一个 Account 类、一个 CheckingAccount 子类,以及各自的一个实例。
Account 类通过 make_account_class 函数创建,其结构与 Python 中的 class 语句相似,但以一次对 make_class 的调用收尾。
>>> def make_account_class():
"""Return the Account class, which has deposit and withdraw methods."""
interest = 0.02
def __init__(self, account_holder):
self['set']('holder', account_holder)
self['set']('balance', 0)
def deposit(self, amount):
"""Increase the account balance by amount and return the new balance."""
new_balance = self['get']('balance') + amount
self['set']('balance', new_balance)
return self['get']('balance')
def withdraw(self, amount):
"""Decrease the account balance by amount and return the new balance."""
balance = self['get']('balance')
if amount > balance:
return 'Insufficient funds'
self['set']('balance', balance - amount)
return self['get']('balance')
return make_class(locals())
最后那次对 locals 的调用,返回一个键为字符串的字典,其中含有当前局部帧里的名字-值绑定。
Account 类最终经由赋值完成实例化。
>>> Account = make_account_class()
接着,通过 new 消息创建一个账户实例,这需要一个与新账户相配的名字。
>>> kirk_account = Account['new']('Kirk')
然后,传给 kirk_account 的 get 消息取回各项属性与方法。方法可以被调用,以更新账户余额。
>>> kirk_account['get']('holder')
'Kirk'
>>> kirk_account['get']('interest')
0.02
>>> kirk_account['get']('deposit')(20)
20
>>> kirk_account['get']('withdraw')(5)
15
与 Python 的对象系统一样,设置实例的属性并不会改变其类中对应的属性。
>>> kirk_account['set']('interest', 0.04)
>>> Account['get']('interest')
0.02
继承。 我们可以通过重载一部分类属性来创建子类 CheckingAccount。在本例中,我们改动 withdraw 方法以收取费用,并调低利率。
>>> def make_checking_account_class():
"""Return the CheckingAccount class, which imposes a $1 withdrawal fee."""
interest = 0.01
withdraw_fee = 1
def withdraw(self, amount):
fee = self['get']('withdraw_fee')
return Account['get']('withdraw')(self, amount + fee)
return make_class(locals(), Account)
在这个实现中,我们从子类的 withdraw 函数里调用基类 Account 的 withdraw 函数,一如在 Python 内置对象系统中那样。与之前一样,我们可以创建子类本身及其一个实例。
>>> CheckingAccount = make_checking_account_class()
>>> spock_acct = CheckingAccount['new']('Spock')
存款行为完全相同,构造器函数亦然。取款时由专门的 withdraw 方法收取 1 美元费用,而利率则取 CheckingAccount 中更低的那个新值。
>>> spock_acct['get']('interest')
0.01
>>> spock_acct['get']('deposit')(20)
20
>>> spock_acct['get']('withdraw')(5)
14
我们这套建立在字典之上的对象系统,在实现上与 Python 的内置对象系统颇为相似。在 Python 中,任何用户自定义类的实例都有一个特殊属性 __dict__,它以字典的形式存储该对象的各局部实例属性,很像我们的 attributes 字典。Python 的不同之处在于,它区分某些特殊方法,这些方法与内置函数交互,以确保那些函数在面对多种不同类型的实参时行为正确。作用于不同类型的函数,正是下一节的题材。
2.7 对象抽象
对象系统让程序员得以构建并使用抽象的数据表示。在设计用户自定义类的行为时,最后一步就是规定其实例如何使用 Python 的内置语法,比如打印、显示、相加、调用,以及对对象取项。
对象抽象中的一个核心概念是泛型函数(generic function)——能够接受多种不同类型值的函数。Python 实现泛型函数最常用的方式,是通过共享的接口。
字符串转换
要有效地表示数据,对象值就应当表现得如同它所要表示的那类数据,其中也包括生成自身的字符串表示。数据值的字符串表示,在 Python 这样一门交互式语言中尤为重要——在交互式会话里,它会自动显示表达式值的字符串表示。
字符串值为人类之间传递信息提供了基本的媒介:一串串字符可以显示在屏幕上、打印到纸上、朗读出来、转换为盲文,或者以摩尔斯电码广播。字符串对编程同样根本,因为它们能够表示 Python 表达式。
Python 规定,所有对象都应当生成两种不同的字符串表示:一种是人类可解读的文本,另一种是 Python 可解读的表达式。字符串的构造器函数 str 返回人类可读的字符串;在可能的情况下,repr 函数则返回一个求值为相等对象的 Python 表达式。repr 的文档字符串这样解释这一性质:
repr(object) -> string
Return the canonical string representation of the object.
For most object types, eval(repr(object)) == object.
对某个表达式的值调用 repr,其结果正是 Python 在交互式会话中打印出来的东西。
>>> 12e12
12000000000000.0
>>> print(repr(12e12))
12000000000000.0
在不存在能够求值为原值的表示时,Python 通常会生成一段用尖括号括起来的描述。
>>> repr(min)
'<built-in function min>'
str 构造器常常与 repr 不谋而合,但在某些情形下会提供更易解读的文本表示。例如,对于日期,str 与 repr 便有所不同。
>>> from datetime import date
>>> tues = date(2011, 9, 12)
>>> repr(tues)
'datetime.date(2011, 9, 12)'
>>> str(tues)
'2011-09-12'
定义 repr 函数带来了一个新难题:我们希望它正确地作用于所有数据类型,甚至是 repr 实现之时尚不存在的那些类型。我们希望它是一个**泛型(generic)或多态(polymorphic)**函数——能够作用于许多(poly)不同形式(morph)的数据。
对象系统为此提供了一种优雅的解法:repr 函数总是调用其参数上名为 __repr__ 的方法。
>>> tues.__repr__()
'datetime.date(2011, 9, 12)'
在用户自定义的类中实现同一个方法,我们便能将 repr 的适用范围扩展到今后所创造的任何类。这个例子也凸显了点表达式的一大好处:它们提供了一种机制,把既有函数的定义域扩展到新的对象类型上。
str 构造器的实现方式类似:它调用其参数上名为 __str__ 的方法。
>>> tues.__str__()
'2011-09-12'
这些多态函数体现了一条更一般的原则:某些函数应当作用于多种数据类型。而且,创建这类函数的一种办法,就是使用同一个共享的方法名,而在每个类中给出不同的定义。
特殊方法
在 Python 中,某些特殊的名字会在特殊场合由 Python 解释器调用。例如,每当对象被构造时,类的 __init__ 方法就会被自动调用;打印时会自动调用 __str__ 方法;而在交互式会话中显示值时,会调用 __repr__。
Python 中还有许多其他行为对应的特殊名字。下面介绍其中最常用的一些。
真值与假值。 我们先前看到,Python 中的数字有真值:具体而言,0 是假值,其他所有数字都是真值。事实上,Python 中的所有对象都有真值。默认情况下,用户自定义类的对象被视为真,但可以用特殊的 __bool__ 方法来覆盖这一行为。若对象定义了 __bool__ 方法,Python 就调用它来确定该对象的真值。
举例来说,假设我们希望余额为 0 的银行账户为假。可以在 Account 类中添加一个 __bool__ 方法来造出这种效果。
>>> Account.__bool__ = lambda self: self.balance != 0
我们可以调用 bool 构造器查看对象的真值,也可以在布尔语境中使用任何对象。
>>> bool(Account('Spock'))
False
>>> if not Account('Spock'):
print('Spock is broke')
Spock is broke
序列操作。 我们已经看到,可以调用 len 函数来确定序列的长度。
>>> len('Go Bears!')
9
len 函数调用其参数上的 __len__ 方法来确定长度。所有内置序列类型都实现了这个方法。
>>> 'Go Bears!'.__len__()
9
若序列没有提供 __bool__ 方法,Python 就用它的长度来确定真值:空序列为假,非空序列为真。
>>> bool('')
False
>>> bool([])
False
>>> bool('Go Bears!')
True
取项运算符会调用 __getitem__ 方法,不过它也可以被直接调用。
>>> 'Go Bears!'[3]
'B'
>>> 'Go Bears!'.__getitem__(3)
'B'
可调用对象。 在 Python 中,函数是一等对象,因此可以作为数据传来传去,并像其他对象一样拥有属性。Python 还允许我们定义能够像函数那样被「调用」的对象——办法是包含一个 __call__ 方法。有了这个方法,我们便能定义一个行为如同高阶函数的类。
举个例子,考虑下面这个高阶函数,它返回一个给其实参加上一个常数的函数。
>>> def make_adder(n):
def adder(k):
return n + k
return adder
>>> add_three = make_adder(3)
>>> add_three(4)
7
我们可以创建一个 Adder 类,定义 __call__ 方法来提供相同的功能。
>>> class Adder:
def __init__(self, n):
self.n = n
def __call__(self, k):
return self.n + k
>>> add_three_obj = Adder(3)
>>> add_three_obj(4)
7
在这里,Adder 类的举止如同 make_adder 高阶函数,而 add_three_obj 对象的举止如同 add_three 函数。我们进一步模糊了数据与函数之间的界线。
算术。 特殊方法还能定义内置运算符(如 + 与 *)作用于用户自定义对象时的行为。为了提供这种一般性,Python 遵循特定的协议来施用每个运算符。例如,要求值含 + 运算符的表达式,Python 会检查该表达式左右两个操作数上的特殊方法:先检查左操作数值上的 __add__ 方法,再检查右操作数值上的 __radd__ 方法;只要找到一个,就以另一操作数的值作为实参调用该方法。下面举一例。有兴趣深究的读者,可参阅 Python 文档中完整的运算符方法名清单;Dive into Python 3 中关于特殊方法名的一章,则描述了其中许多特殊方法名的用法。
示例:分数
整数之比,也称有理数(rational number),是一种重要的数。像 1/3 或 17/29 这样的有理数,通常写作:
<numerator>/<denominator>
其中 <numerator>(分子)与 <denominator>(分母)都是整数值的占位符。要精确刻画这个比值,两部分缺一不可。而真正把两个整数相除,得到的却是浮点近似值,整数的那份精确就丢失了。
>>> 1/3
0.3333333333333333
>>> 1/3 == 0.3333333333333333 # 整数相除得到的是近似值
True
不过,我们可以用一个类为分数造出精确的表示。下面定义的类以最简形式存储分数:把传入的分子与分母都除以它们的最大公约数。这些特殊方法在显示、相加与相乘分数时提供了恰当的行为。
>>> from __future__ import annotations
>>> import math
>>> class Ratio:
"A ratio of integers: numer / denom"
def __init__(self, n: int, d: int):
g = math.gcd(n, d)
self.numer = n // g
self.denom = d // g
def __str__(self):
return f'{self.numer}/{self.denom}'
def __repr__(self):
return f'Ratio({self.numer}, {self.denom})'
def __add__(self, other: Ratio):
return Ratio(self.numer * other.denom + other.numer * self.denom,
self.denom * other.denom)
def __mul__(self, other: Ratio):
return Ratio(self.numer * other.numer, self.denom * other.denom)
>>> half = Ratio(2, 4)
>>> half
Ratio(1, 2)
>>> print(half)
1/2
>>> fifth = Ratio(1, 5)
>>> print(half * fifth)
1/10
>>> print(fifth + fifth)
2/5
如上例所示,我们的有理数实现每构造一个分数,都会把它约到最简形式,因此 fifth + fifth 是五分之二,而不是二十五分之十。
2.8 惰性求值
Python 并不执行新创建函数的函数体,而是等到该函数被调用时再执行。定义函数,创造了为任何输入计算结果的可能性,但真正的计算被推迟到有人请求之时。
这种「先搭好计算的架子、只在被请求时才真正执行」的模式,可以推广到函数之外的其他对象。本节我们把这一模式扩展到序列:创建这样的对象,它能按顺序计算序列的各项,但在被催促之前并不真正计算它们。
惰性求值。 宽泛地说,**惰性求值(lazy evaluation)一词描述的正是「先搭好、再推迟到需要时才计算」,与及早求值(eager evaluation)**相对——后者指一描述完就立即执行计算。一个简单的对照是下面两个返回斐波那契数的函数 lazy_fib 与 eager_fib。(下标 −2 是列表的倒数第二项,−1 是最后一个下标。)
>>> eager_cache = [0, 1]
>>> for _ in range(2, 100):
eager_cache.append(eager_cache[-2] + eager_cache[-1])
>>> def eager_fib(n):
assert n < 100
return eager_cache[n]
>>> lazy_cache = [0, 1]
>>> def lazy_fib(n):
while len(lazy_cache) < n + 1:
lazy_cache.append(lazy_cache[-2] + lazy_cache[-1])
return lazy_cache[n]
>>> eager_fib(15), lazy_fib(15)
(610, 610)
>>> eager_fib(10), lazy_fib(10)
(55, 55)
>>> eager_fib(20), lazy_fib(20)
(6765, 6765)
惰性求值无论是对于效率还是交互性,都颇有用处。若创建了一长串值,却只有少数几个被用于计算某个真正关心的最终结果,那么把其余的都造出来便是浪费。此外,当软件被交互式地使用时,用户往往会接连提出一串请求;软件应当准备好应答每一个请求,但直到请求到来才执行计算。惰性求值还可以更灵活,如上例所示:eager_fib 受限于 n < 100,而 lazy_fib 只受计算机内存的约束。
隐式序列。 序列的表示,未必需要把每一项都显式存储在计算机内存中。也就是说,我们可以构造这样一个对象:它提供对某个序列数据集全部各项的访问,却不预先计算每一项的值,而是按需计算。
2.2 节引入的 range 容器类型,便是这一思想的一例。range 表示一段连续而有界的整数序列,但并非其中每一项都被显式地表示在内存里;相反,当从 range 请求某一项时,才把它算出来。因此,我们可以表示极大的整数区间,而不必占用大块内存——range 对象只存储其端点。
>>> r = range(10000, 1000000000)
>>> r[45006230]
45016230
在这个例子里,构造 range 实例时,那 999,990,000 个整数并没有被全部存储;相反,range 对象把首项 10,000 加上下标 45,006,230,得出该项 45,016,230。按需计算值,而非从既有的表示中取出值,是惰性求值的又一例。
迭代器
Python 以及许多其他编程语言,提供了一种统一的办法来顺次处理容器中的各项,称为迭代器(iterator)。迭代器是逐个地、顺序地提供值访问的对象。
迭代器抽象是一种机制:取出正在处理的序列中的下一项,从而使迭代器向前推进。在 Python 中,对任何容器(如列表或 range)调用内置的 iter 函数,都能得到一个迭代器;迭代器的内容则可通过调用内置的 next 函数访问。
>>> primes = [2, 3, 5, 7]
>>> type(primes)
<class 'list'>
>>> iterator = iter(primes)
>>> type(iterator)
<class 'list_iterator'>
>>> next(iterator)
2
>>> next(iterator)
3
>>> next(iterator)
5
在 Python 中,若某个迭代器已经越过了它所表示序列的最后一项,再对它调用 next 就会出错。
>>> next(iterator)
7
>>> next(iterator)
Traceback (most recent call last):
File "<stdin>", line 1, in <module>
StopIteration
迭代器维护着表示其在序列中位置的局部状态;每调用一次 next,位置便向前推进。两个彼此独立的迭代器,可以在同一个序列中追踪两个不同的位置;但同一个迭代器的两个名字,则会共享同一个位置,因为它们都是同一个迭代器对象的别名。
>>> r = range(3, 13)
>>> s = iter(r) # r 上的第 1 个迭代器
>>> next(s)
3
>>> next(s)
4
>>> t = iter(r) # r 上的第 2 个迭代器
>>> next(t)
3
>>> next(t)
4
>>> u = t # 第 2 个迭代器的另一个名字
>>> next(u)
5
>>> next(u)
6
推进第二个迭代器并不影响第一个。由于第一个迭代器最后返回的值是 4,它下一步将返回 5;而第二个迭代器下一步将返回 7。
>>> next(s)
5
>>> next(t)
7
对一个迭代器调用 iter,返回的是该迭代器本身,而非副本。Python 纳入这一行为,是为了让程序员能放心地对某个值调用 iter 以取得迭代器,而不必操心它究竟是迭代器还是容器。
>>> v = iter(t) # 第 2 个迭代器的又一个名字
>>> next(v)
8
>>> next(u)
9
>>> next(t)
10
迭代器的用处,源于这样一个事实:迭代器底层的那个数据系列,未必被显式地表示在内存中。迭代器提供了一种机制,让我们得以逐一考察一系列值,而不必把这些项同时全部存储起来。相反,当从迭代器请求下一项时,那一项可以按需计算,而非从内存中取出——这正是惰性求值的一例。
range 之所以能惰性地计算序列各项,是因为它所表示的序列是规整的,任何一项都容易从区间的起止边界算出。迭代器则使得更广泛的一类底层序列数据集能够被惰性生成,因为它们无需提供对底层序列任意项的访问;迭代器只要求按顺序算出序列的下一项,每当又有一项被请求时便算一项。这种对序列数据的**顺序访问(sequential access)虽不如访问序列任意项的随机访问(random access)**灵活,但对数据处理应用而言,往往已然够用。
可迭代值
凡是能产生迭代器的值,都称为可迭代值(iterable value)。在 Python 中,可迭代值就是任何能传给内置 iter 函数的东西。可迭代值包括字符串、元组之类的序列值,也包括集合、字典等其他容器。
>>> d = {'one': 1, 'two': 2, 'three': 3}
>>> d
{'one': 1, 'two': 2, 'three': 3}
>>> k = iter(d)
>>> next(k)
'one'
>>> next(k)
'two'
>>> v = iter(d.values())
>>> next(v)
1
>>> next(v)
2
迭代器本身也是可迭代值,因为它们也能传给 iter 函数。
内置迭代器
若干内置函数接受可迭代值为实参,返回迭代器。这些函数被广泛用于惰性的序列处理。
map 函数是惰性的:调用它并不会执行算出其结果各项所需的计算,而是创建一个迭代器对象,只有在用 next 查询时才返回结果。下面的例子可以观察到这一事实:直到从 doubled 迭代器请求相应项时,对 print 的调用才发生。
>>> def double_and_print(x):
print('***', x, '=>', 2*x, '***')
return 2*x
>>> s = range(3, 7)
>>> doubled = map(double_and_print, s) # 尚未调用 double_and_print
>>> next(doubled) # 调用了一次 double_and_print
*** 3 => 6 ***
6
>>> next(doubled) # 又调用了一次
*** 4 => 8 ***
8
>>> list(doubled) # 又调用了两次
*** 5 => 10 ***
*** 6 => 12 ***
[10, 12]
filter、zip 与 reversed 函数同样返回迭代器。
for 语句
Python 的 for 语句就作用于迭代器。任何可迭代对象都可以充当 for 语句头部 <expression> 的值:
for <name> in <expression>:
<suite>
要执行 for 语句,Python 先求值头部 <expression>,它必须得出一个可迭代值;然后对该值调用 iter。在抛出 StopIteration 异常之前,Python 反复对其迭代器调用 next,把结果绑定到 for 语句中的 <name>,并执行 <suite>。
>>> counts = [1, 2, 3]
>>> for item in counts:
print(item)
1
2
3
在上例中,counts 列表提供了一个列表迭代器;for 语句随后反复对其调用 next,每次都把返回的值赋给 item。这一过程持续到迭代器抛出 StopIteration 异常为止,此时 for 语句的执行便告结束。
生成器与 yield 语句
**生成器(generator)**是由一类特殊函数——生成器函数(generator function)——返回的迭代器。生成器函数与普通函数的区别在于:它们用 yield 语句来产生序列的各项。
生成器控制着其生成器函数的执行:每次对生成器调用 next,生成器函数便从上次停下的地方继续运行,直到执行到下一条 yield 语句。
>>> def letters_generator():
current = 'a'
while current <= 'd':
yield current
current = chr(ord(current)+1)
>>> for letter in letters_generator():
print(letter)
a
b
c
d
yield 语句标志着我们在定义一个生成器函数。被调用时,生成器函数并不返回某个具体的产出值,而是返回一个生成器(属于迭代器的一种),它可以产生那些产出的值。对生成器调用 next,会从生成器函数上次停下的地方继续执行,直到执行下一条 yield 语句。
第一次调用 next 时,程序从 letters_generator 函数体的语句开始执行,直到遇到 yield 语句;然后暂停,返回 current 的值。yield 语句并不退出生成器函数,也不移除其环境;相反,再次调用 next 时,生成器函数的函数体会从上次停下的地方继续执行。current 以及 letters_generator 作用域中任何其他绑定名字的值,都会在随后对各次 next 的调用之间得以保留。
我们可以手动调用 next 来把这个生成器走一遍:
>>> letters = letters_generator()
>>> type(letters)
<class 'generator'>
>>> next(letters)
'a'
>>> next(letters)
'b'
>>> next(letters)
'c'
>>> next(letters)
'd'
>>> next(letters)
Traceback (most recent call last):
File "<stdin>", line 1, in <module>
StopIteration
在第一次对它调用 next 之前,生成器不会开始执行其生成器函数体中的任何语句。每当其生成器函数返回,生成器便抛出 StopIteration 异常。
生成器函数使任意序列都能被惰性求值:任何值序列都可以用生成器函数来定义,而在对其生成器调用 next 请求各项之前,一项都不会被计算。
从可迭代值中产出。 yield from 语句会产出某个可迭代值中的所有项,它等价于遍历该可迭代值并逐项产出。下面两种 range_twice 的实现是等价的。
>>> def range_twice(a, b):
yield from range(a, b)
yield from range(a, b)
>>> list(range_twice(2, 6))
[2, 3, 4, 5, 2, 3, 4, 5]
>>> def range_twice(a, b):
for x in range(a, b):
yield x
for x in range(a, b):
yield x
>>> list(range_twice(2, 6))
[2, 3, 4, 5, 2, 3, 4, 5]
多个生成器。 对同一个生成器函数多次调用,会创建多个生成器,每个都追踪自己在函数体中的环境与位置。下面的例子展示三个生成器,以及分别多次调用 next 的结果。
>>> def squares_and_cubes(n):
while n < 5:
yield n * n
yield n * n * n
n = n + 1
>>> a = squares_and_cubes(3) # 9, 27, 16, 64
>>> next(a)
9
>>> b = squares_and_cubes(3) # 9, 27, 16, 64
>>> next(a)
27
>>> next(b) # b 不受 next(a) 调用的影响
9
>>> next(a)
16
>>> c = squares_and_cubes(2) # 4, 8, 9, 27, 16, 64
>>> next(c)
4
>>> for v in b:
print('the next item in b is', v)
the next item in b is 27
the next item in b is 16
the next item in b is 64
>>> list(c)
[8, 9, 27, 16, 64]
>>> list(c) # c 已没有剩余项
[]
>>> list(a)
[64]
无限生成器。 由于生成器函数的函数体是惰性执行的,只要始终只用 next 或 for 请求其中一段前缀,它就有可能计算并产出无穷多个值,而不会让程序永不停歇。
例如,这个函数遍历所有正数的平方。
>>> def squares(n):
while True:
yield n * n
n = n + 1
>>> all_squares = squares(1)
>>> [next(all_squares), next(all_squares), next(all_squares)]
[1, 4, 9]
然而,调用 list(squares(1)) 会启动一场无穷无尽的计算,耗光所有可用内存,然后报错。
递归生成器
生成器函数可以调用自身。每次调用生成器函数都返回一个生成器,因此递归调用的结果需要加以处理——最常见的是用 for 语句。
2.3 节定义的 partitions 函数,返回用不超过 m 的部分划分 n 的一个列表;那个函数是及早计算所有划分的。下面这个版本则惰性地计算同样的划分。
>>> def partitions_gen(n: int, m: int):
"""Yield partitions of n using parts of up to m.
Each partition is represented as a linked list.
"""
if n == 0:
yield () # 空划分
elif n > 0 and m > 0:
for p in partitions_gen(n-m, m):
yield Link(m, p)
yield from partitions_gen(n, m-1)
partitions_gen 函数既更短,也更高效。即便需要全部划分,生成器函数也更高效,因为它不必把较短列表的内容复制进较长的列表(而 partitions 用表达式 with_m + without_m 正是这么做的)。不过,主要的效率优势出现在只需要一部分划分之时:partitions_gen 只创建所需的那些划分,而非每一个可能的划分。
效率对比。 在一台普通笔记本电脑上,仅仅打印 partitions(55, 20) 的前 10 项,就要花上约 5 秒——因为它要创建一份含全部 385,528 种划分的列表,并对 partitions 发起 5,475,736 次递归调用。
>>> for p in partitions(55, 20)[:10]:
print(p)
(20 20 15)
(20 20 14 1)
(20 20 13 2)
(20 20 13 1 1)
(20 20 12 3)
(20 20 12 2 1)
(20 20 12 1 1 1)
(20 20 11 4)
(20 20 11 3 1)
(20 20 11 2 2)
若对 partitions_gen 返回的生成器调用 next 10 次,同样这 10 种划分也能被打印出来——这只需约 20 微秒,快了 20 万倍以上。它只创建所请求的那 10 种 55 的划分,总共只产生 45 种划分(包括沿途较小数的划分),仅经历 135 次递归调用。
>>> parts = partitions_gen(55, 20)
>>> for _ in range(10):
print(next(parts))
(20 20 15)
(20 20 14 1)
(20 20 13 2)
(20 20 13 1 1)
(20 20 12 3)
(20 20 12 2 1)
(20 20 12 1 1 1)
(20 20 11 4)
(20 20 11 3 1)
(20 20 11 2 2)
下表总结了用不超过 20 的部分打印 55 的前 10 种划分所需的工作量。「创建的划分」包含沿途构造的较小数的划分,以所构造的 Link 实例数计。
| partitions | partitions_gen | |
|---|---|---|
| 时间 | 约 5,000,000 微秒 | 约 20 微秒 |
| 创建的划分 | 5,901,019 | 45 |
| 递归调用 | 5,475,736 | 135 |
随着 n 与 m 增大,这一加速比还会增长:那些会耗尽内存、partitions 要跑上数十亿年的输入,只要用 next 请求少量划分,partitions_gen 瞬间便能应付。
>>> parts = partitions_gen(1000, 300)
>>> for _ in range(10):
print(next(parts))
(300 300 300 100)
(300 300 300 99 1)
(300 300 300 98 2)
(300 300 300 98 1 1)
(300 300 300 97 3)
(300 300 300 97 2 1)
(300 300 300 97 1 1 1)
(300 300 300 96 4)
(300 300 300 96 3 1)
(300 300 300 96 2 2)
相比之下,partitions(1000, 300) 会构造一份列表,含 1000 用不超过 300 的部分划分的全部 2.4×10³¹ 种划分,总共创建约 2.3×10³³ 种划分,经历约 1.2×10³³ 次递归调用。即便内存无限,按上表所测的每次递归调用约 1 微秒的速度,这场计算也要花上约 4×10¹⁹ 年——比宇宙的年龄还长数十亿倍。
附录:示例
本书的配套代码。每个 Python 文件都可以单独下载并运行;其文档字符串中包含文档测试(python3 -m doctest -v link.py)。
Hog Two Ways
Hog Two Ways 是一个使用 Gleam 语言的项目,它把 Python 版 Hog 游戏中的可变骰子函数,替换为显式状态处理与状态传递两种写法。整个项目可下载为 dice.zip。
link.py
2.3 节中用于链表的 Link 数据类,附有一个把链表格式化为「各项置于圆括号内」的 __str__ 方法。
源码:link.py
想看链表的盒指针图,可把它的 repr 或 str 粘贴到绘图工具中。
from __future__ import annotations
from dataclasses import dataclass
type LinkedList[T] = Link[T] | tuple[()]
@dataclass
class Link[T]:
"""A Link has a first value of type T and the rest of the linked list.
The rest is either another Link or the empty tuple.
>>> s = Link(3, Link(4, Link(5)))
>>> s.first
3
>>> s.rest.first
4
>>> s.rest.rest.first
5
>>> s.rest.rest.rest == ()
True
>>> s
Link(first=3, rest=Link(first=4, rest=Link(first=5, rest=())))
>>> s.rest.rest
Link(first=5, rest=())
>>> print(s)
(3 4 5)
"""
first: T
rest: LinkedList[T] = () # rest 默认为空链表
def __str__(self):
return format_link(self)
def format_link(s: Link):
"""Return a Link s formatted as items within parentheses."""
string = '(' + str(s.first)
remaining = s.rest
while isinstance(remaining, Link):
string += ' ' + str(remaining.first)
remaining = remaining.rest
assert remaining == (), f'{s!r} is not a LinkedList'
return string + ')'
tree.py
2.3 节中的 Tree 数据类,附有一个把每个分支缩进打印在其标签之下的 __str__ 方法。
源码:tree.py
绘图工具可以从它的 repr 或 str 画出树形。
from __future__ import annotations
from dataclasses import dataclass, field
@dataclass
class Tree[T]:
"""A Tree has a label (of type T) and a list of branches, which are trees.
>>> t = Tree(3, [Tree(1, []), Tree(2, [Tree(1, []), Tree(1, [])])])
>>> t.branches[0]
Tree(label=1, branches=[])
>>> len(t.branches)
2
>>> t.branches[1].label
2
>>> len(t.branches[1].branches)
2
>>> expr = Tree(10, [Tree(6, [Tree(2), Tree('*'), Tree(3)]), Tree('+'), Tree(4)])
>>> print(expr)
10
6
2
*
3
+
4
"""
label: T
branches: list[Tree[T]] = field(default_factory=list) # branches 默认为 []
def __str__(self):
return format_tree(self)
def format_tree(t: Tree, indent='') -> str:
"Format a tree with each branch indented below its label."
assert isinstance(t, Tree), f'{t!r} is not a Tree'
assert isinstance(t.branches, list), f'branches of {t!r} is not a list'
string = indent + str(t.label)
for b in t.branches:
string += '\n' + format_tree(b, indent + ' ')
return string
def is_leaf(t: Tree) -> bool:
"Return whether a Tree t is a leaf with no branches."
return not t.branches